生产级 AI Agent 项目实施手册:从需求到可运行系统
从可验收的规格写到上线检查。先交出一个能停、能说明失败、能重放的单 Agent,再按真实风险加组件。
2026-10-01 · 实施手册
本文挂在 thinking。
1. 先把“要做什么”写成可验收的项目规格
编程 Agent 最容易在需求不清时过度设计:擅自选云厂商、数据库、权限模型,或把“能回答问题”误当作“能安全完成任务”。进入编码前先把业务目标变成可测试的规格,明确 Agent 能做什么、不能做什么、失败后由谁处理。以下“接收请求、调用受控工具、返回结果”仅是中立的接口示例,不代表任何特定业务需求。
先写规格
项目规格至少应有这些字段
| 规格字段 | 要写清楚的内容 | 可验收的写法示例(需按真实业务替换) |
|---|---|---|
| 目标与非目标 | 用户希望完成的任务;明确不做什么 | “把请求转换成受控查询并解释结果”;“不自动修改外部记录” |
| 用户与身份 | 谁发起请求、身份如何验证、是否多租户、资源归属在哪里判定 | 用户身份来自已验证的 JWT;不能相信请求体内自行填写的 tenant_id |
| 输入和数据分类 | 用户输入、外部文档、个人信息、机密、保留与删除规则 | 分类为公开/内部/敏感;提示、工具结果及 trace 的保存要求分别定义 |
| 允许动作 | 工具、读写权限、允许的目标对象、禁止动作 | 允许查询本人可见记录;“发送、删除、发布”等需明确批准策略 |
| 失败与停止 | 信息不足、拒绝、超时、超预算、工具失败时如何结束 | 返回明确错误码;写操作状态不确定时转 RECONCILIATION_REQUIRED,不盲目重试 |
| 性能和成本 | 任务级 SLO、并发/峰值、延迟百分位、token/调用/任务预算 | 指明测量入口到最终结果的 p95/p99,不只写模型 token/s |
| 部署约束 | 单机/容器/平台、网络、区域、机密管理、已有服务 | 未选定时标记为待决,不替用户选具体云服务 |
| 验收样例 | 正常、边界、失败、权限、注入、重复请求样例 | 每个关键动作有可复现的输入、预期状态、预期副作用和拒绝行为 |
现在就可确认的架构变量通常只有会改变系统形状的问题:有无写操作或不可逆动作;是否多租户;是否需要后台运行/审批/进程重启后恢复;最大任务时长;数据能否发送到外部模型及保留策略;硬性 SLO/成本上限;已有技术栈与部署边界。模型选型、缓存 TTL、Kubernetes 是否需要等可以在证据不足时先做决策记录,不应冒充用户要求。
风险和验收的落地格式
为每个危险动作写“威胁,控制,测试,证据”。例如:误向错误记录写入,服务端资源授权 + 预览审批 + 下游幂等键,尝试跨租户与重复调用,保存拒绝日志和下游只出现一条变更的测试证据。安全要由运行时权限、输入校验和业务不变量保证,不能把提示词当作授权系统。OWASP 授权指南要求每次请求进行服务端权限检查、默认拒绝;NIST 零信任架构强调不能只因网络位置而隐式信任资源访问。
验收计划分成:接口契约(请求/响应和错误)、领域行为(结果和副作用)、安全(越权/注入/泄露)、可靠性(超时/重试/故障恢复)、性能(真实任务负载下分位数与成本)、运营(告警、回滚、值班步骤)。任何指标门槛若无业务依据,先在 TBD 中记录要由谁决定,别编出看似精确的 SLO。
2. 选一个足够具体的示范技术栈,不把示范误当成要求
为说明目录和接口,本手册用 Python 3.12 + FastAPI + PostgreSQL;Redis 只作为跨实例限流/缓存或队列基础设施的可选组件;长时间、可等待审批或必须可恢复的任务,按需选择普通队列或 Temporal 类持久工作流;交付以容器为例。它是一种可执行的示范组合,不是唯一答案,也不代表用户已经选定它。
先从单进程、单应用、一个关系数据库、一个模型适配器和一个受限 Agent 循环开始。可以省略 Redis、独立 API Gateway、独立 LLM Gateway、队列、Temporal、Kubernetes、多区部署和多 Agent。什么时候加组件由风险、可用性目标、峰值容量、任务时长、重放/审批要求和团队运维能力决定,而不是“生产级”标签。
| 需求与约束 | 起步实现 | 何时升级/替代 |
|---|---|---|
| 小流量、同步任务、单实例 | FastAPI + PostgreSQL;进程内并发保护仅可作为单实例临时控制 | 多实例需要共享配额/限流时加 Redis 或网关;跨重启任务需数据库/队列持久状态 |
| 固定、短暂后台任务 | PostgreSQL job table 或已有队列;任务状态仍落持久存储 | 高吞吐削峰、消费者隔离或多类任务时用托管队列/Redis Streams 等;确认投递与去重语义 |
| 长时间流程、定时器、人工审批、任意步骤恢复 | Temporal 类持久工作流,或云工作流服务 | 对照 workflow history、活动重试、Signal/审批、版本升级、运维成本;简单任务不必引入 |
| 外部 API 流量门面 | 起步用应用本身,或已有反向代理 | 多团队公共 API、API key、版本门面、集中流控需要时再选 API Gateway |
| 多模型 provider / 模型配额治理 | 应用中的 provider adapter + 简单路由策略 | 多团队共享模型、集中密钥/配额、统一模型日志策略时评估 LLM Gateway |
| 需要故障域隔离/弹性编排 | 单容器 Compose 或现有平台 | 多服务、多团队发布、弹性与自愈需求证明后上 Kubernetes;多区需明确定义 RTO/RPO |
FastAPI 的官方多文件教程示范 APIRouter、依赖和目录拆分,Settings 教程示范使用 Pydantic Settings 并缓存配置对象;SQLAlchemy Session 应有清晰且短的事务边界;Alembic migration 是需要审阅和运行的版本变更,而非自动正确。参见 FastAPI 多文件应用、FastAPI Settings、SQLAlchemy Session、Alembic Tutorial。
一个可以按项目缩减的仓库目录
agent-service/
├── pyproject.toml                 # 依赖与工具配置;提交锁文件
├── .python-version                # 团队约定 Python 版本(可选)
├── .env.example                   # 无真实秘密的变量名和说明
├── .gitignore
├── Dockerfile
├── compose.yaml                   # 本地依赖;不用容器时可省
├── alembic.ini
├── alembic/
│   ├── env.py
│   └── versions/
├── app/
│   ├── main.py                    # FastAPI 工厂、middleware、router
│   ├── config.py                  # Settings、配置校验
│   ├── dependencies.py            # principal、DB session 等依赖
│   ├── api/
│   │   ├── errors.py              # 稳定错误映射
│   │   ├── middleware.py          # request-id、访问日志等横切逻辑
│   │   └── routes/                # runs.py、health.py
│   ├── domain/
│   │   ├── models.py              # AgentRun、ToolInvocation 等领域类型
│   │   ├── policies.py            # 权限、审批与状态转换规则
│   │   └── services.py            # 用例服务,不依赖 HTTP 细节
│   ├── agent/
│   │   ├── loop.py                # 有界 control loop
│   │   ├── prompts/               # 版本化模板,不放密钥
│   │   └── schemas.py
│   ├── llm/
│   │   ├── protocol.py            # ModelClient / provider 中立类型
│   │   ├── router.py              # 可测的模型选择策略
│   │   └── providers/             # openai.py、anthropic.py 等按需添加
│   ├── tools/
│   │   ├── registry.py            # ToolSpec 与 JSON Schema 验证
│   │   ├── executor.py            # 授权、幂等、审批、下游调用
│   │   └── implementations/       # 每个受控动作独立适配器
│   ├── db/
│   │   ├── session.py
│   │   ├── tables.py
│   │   └── repositories.py
│   ├── jobs/                      # 只有异步/持久任务需要
│   └── observability/             # OTel 配置、脱敏、指标
├── tests/
│   ├── unit/                      # 状态机、schema、预算
│   ├── integration/               # 临时 PostgreSQL、API、provider mock
│   ├── evals/                     # 版本化任务集与评分器
│   └── security/                  # 越权、注入、敏感数据用例
└── docs/
    ├── spec.md
    ├── adr/                       # 决策及取舍记录
    ├── runbooks/                  # 故障、发布、回滚手册
    └── evals.md
按团队规模可合并模块;关键是依赖方向:路由解析 HTTP,不写 Agent 业务;Agent 调 ModelClient 和 ToolExecutor 抽象,不直接访问数据库或云 SDK;具体工具在执行前经过策略;持久化状态由 repository/事务管理。不需要为了目录好看拆成大量微服务。
本地环境与迁移怎么落地
固定 Python 版本和依赖锁文件。在 Linux/macOS 可用 python3.12 -m venv .venv 创建本地隔离环境,再用锁文件安装;不要提交 .venv,虚拟环境通常含绝对路径脚本,移动后应重建。Python 3.12 venv。.env.example 只记录字段名和虚构例值,.env 加入 .gitignore;生产 secret 由目标部署环境提供。
应用 Settings 与 Alembic env.py 应读取同一配置来源,避免应用和迁移意外连到不同数据库。每个 schema 改动生成一个可审阅 migration;在临时 PostgreSQL 上从空库 upgrade head,并验证数据迁移、索引、约束和必要 downgrade。不要在每次 HTTP 请求或生产进程 import 时自动 create_all() 或迁移。SQLAlchemy 出错事务须回滚后才能继续复用 session;多步业务写入放在一个明确事务中,由数据库保证原子性。PostgreSQL 事务。
最小本地命令示例(工具名可按锁文件替换):
python3.12 -m venv .venv
.venv/bin/pip install -e '.[dev]'
cp .env.example .env
# 启动 PostgreSQL(若使用 Compose)
docker compose up -d db
.venv/bin/alembic upgrade head
.venv/bin/pytest -q
.venv/bin/ruff check .
.venv/bin/uvicorn app.main:app --reload
配置测试要覆盖缺少必需变量、非法 URL、测试覆盖值及 secret 不进入日志;依赖配置不能靠开发者“记得先 export”。
3. HTTP 入口、Gateway 与中间件:哪一层负责什么
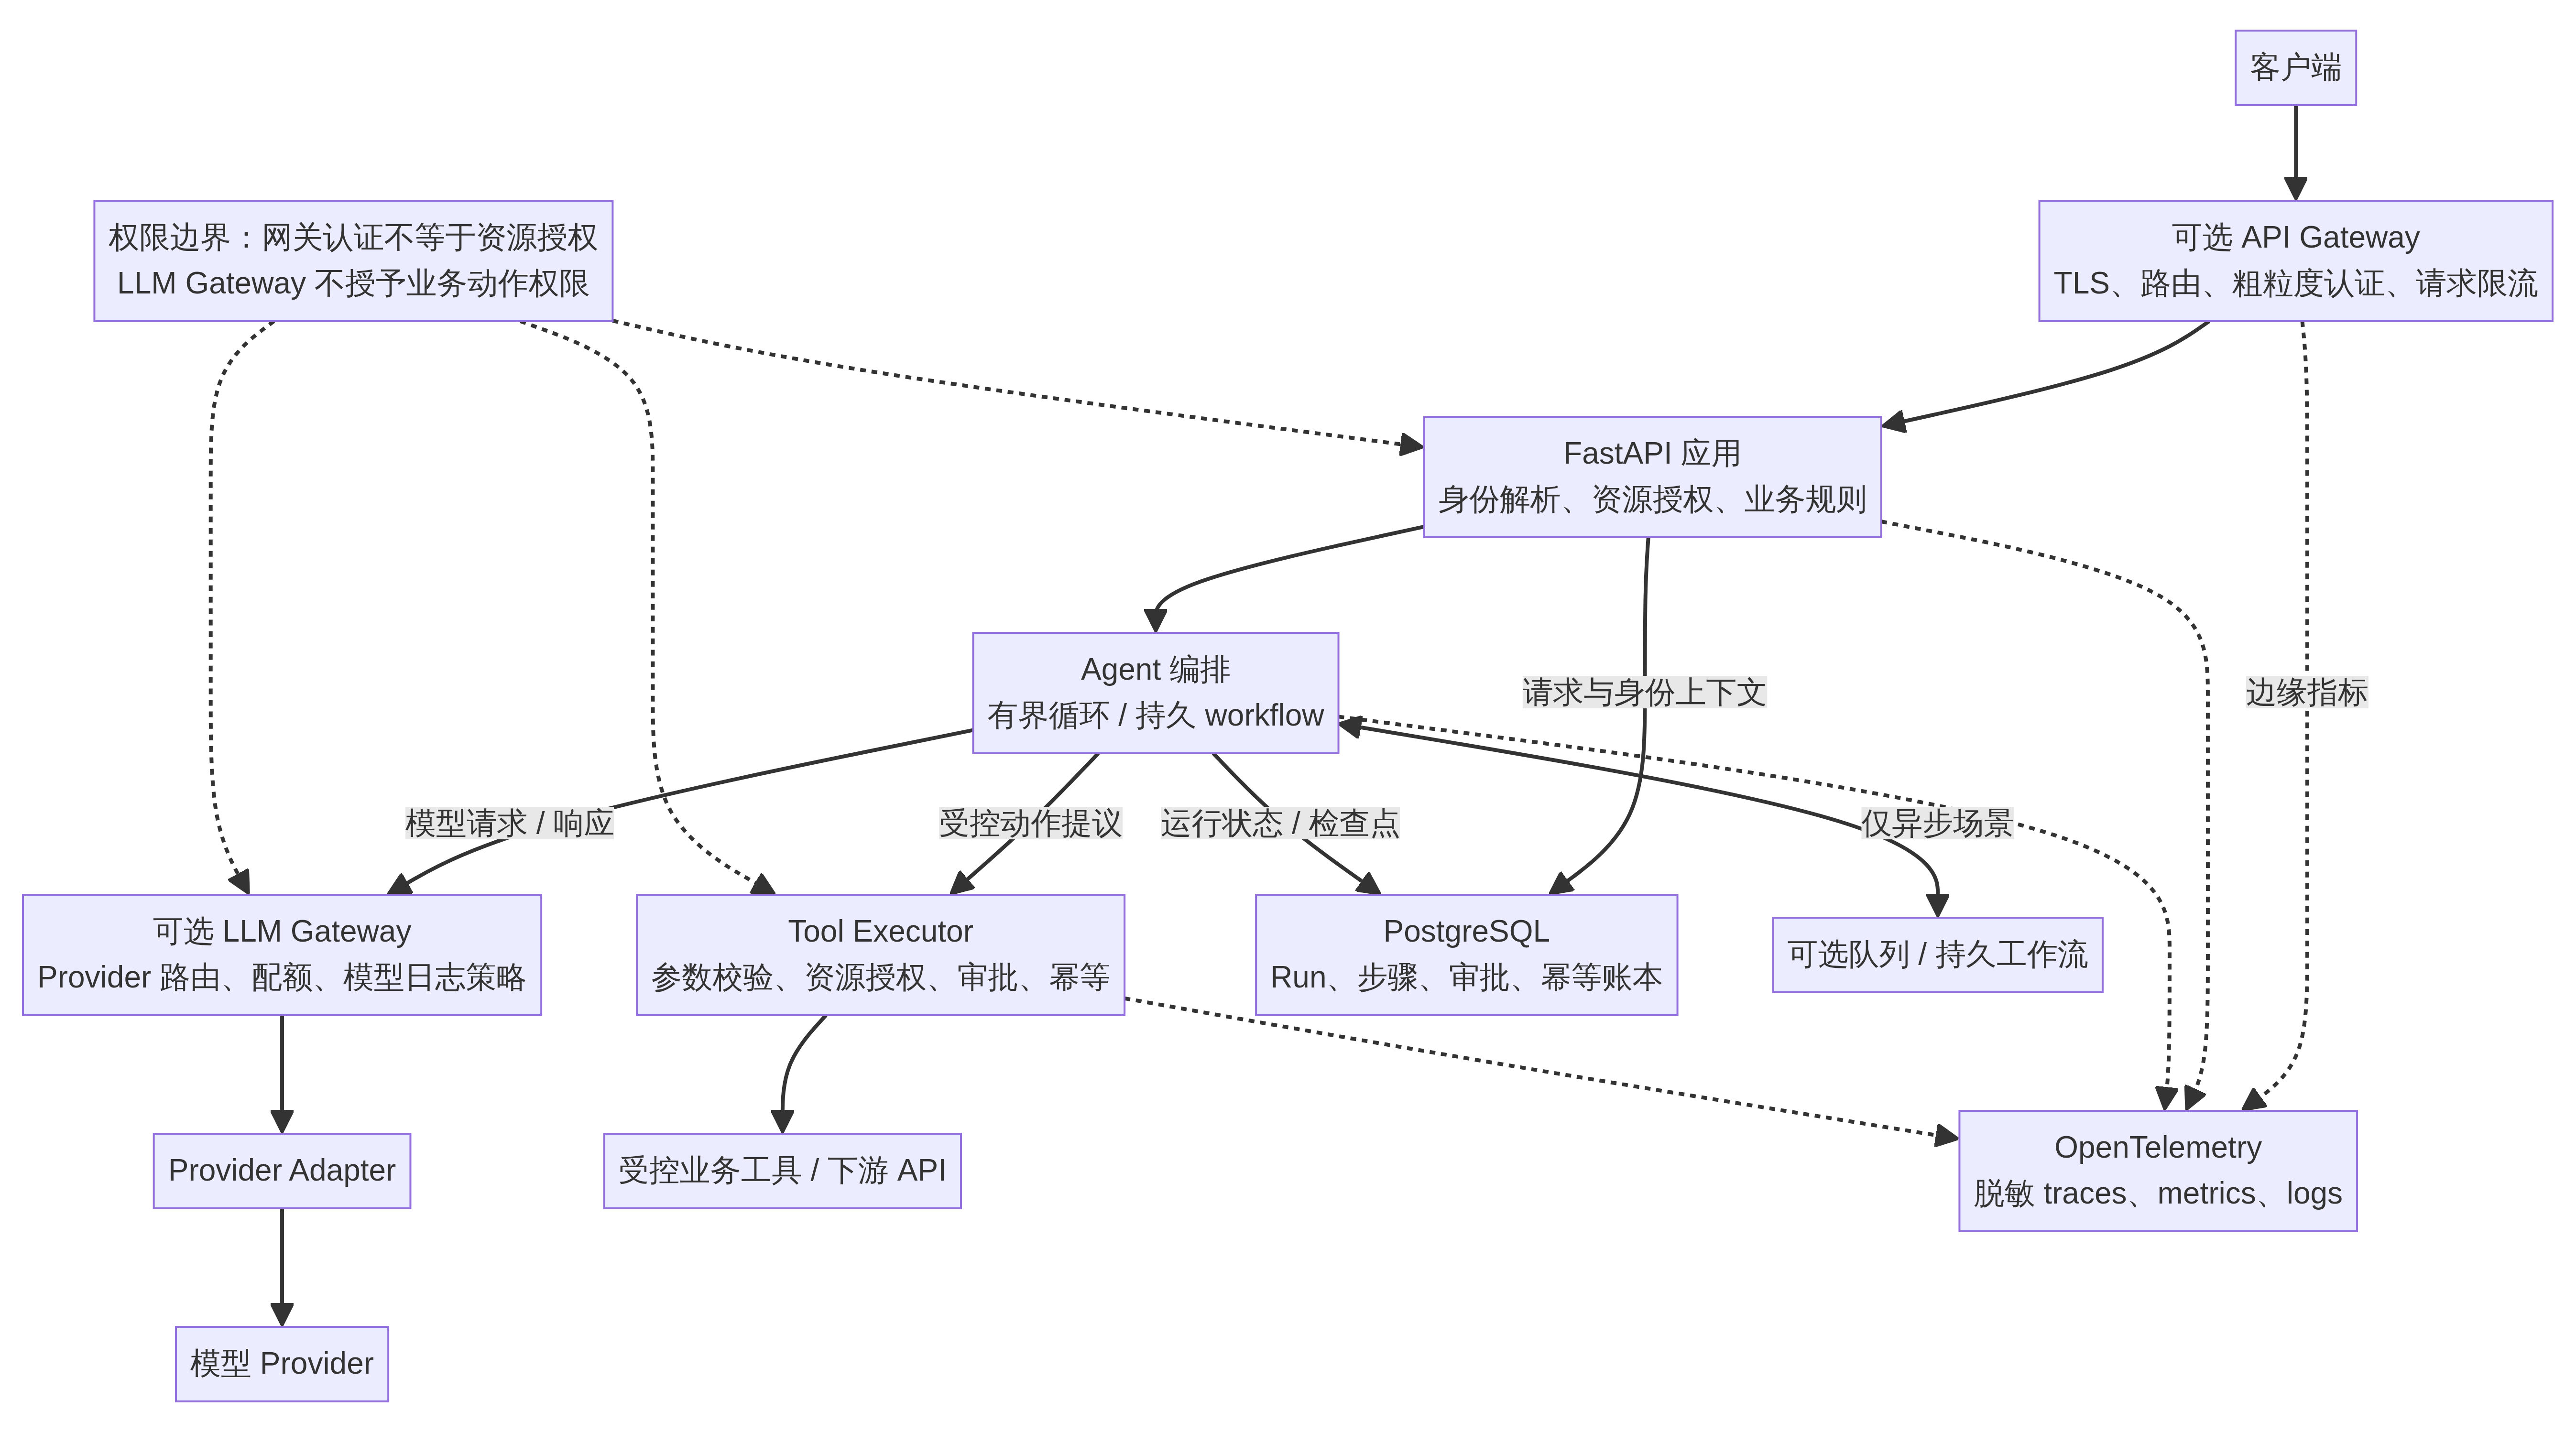
一次请求的典型入口是:TLS/反向代理,(可选)API Gateway,FastAPI middleware,身份解析依赖,路由 schema 校验,领域用例,Agent service。HTTP Gateway 可做域名/TLS、路由、粗粒度认证、API 版本、请求级限流与流量观测;应用负责领域授权、租户资源归属、业务不变量、事务和稳定错误语义。AWS 把 API Gateway 描述为 API 管理与保护的 front door;Azure API Management 也列出路由、安全、节流、缓存、观察等能力,见 AWS API Gateway 与 Azure API Management 概念。
API Gateway 不等于业务授权。Gateway 认证出用户,仍不能据此推断用户可以读取任意 resource_id;应用每次操作要检查已验证主体、租户、资源归属、动作和上下文。只有可信代理网段提供的转发头才可信;不能直接采用客户端伪造的 X-Forwarded-For。Gateway 与应用若同时限流,需明确各自 key、算法、配额和降级策略,避免责任冲突。
LLM Gateway 解决的是模型流量治理,不是 HTTP 领域逻辑。可选地统一 provider 路由、模型凭据、模型级配额、故障切换、内容安全和模型调用审计;不应决定某业务用户是否可删除某客户记录。可见 Azure AI Gateway 能力。不需要集中多模型治理时,应用内一个 adapter 往往更易理解。
FastAPI middleware 适合 request-id、耗时、可信代理、安全头、跨域和未处理异常转化;带资源的认证/授权更适合明确依赖和领域服务,避免一层“全能 middleware”。FastAPI middleware 的请求/响应执行顺序是栈式,多个 middleware 时要用测试固定顺序。FastAPI Middleware。对流式响应,日志中间件不要为了记录正文而缓冲完整响应,否则会取消流式带来的首 token 优势并耗尽内存。
建议 HTTP 契约:POST /v1/runs 创建运行,携带可选 Idempotency-Key;同步短任务返回最终结果,异步任务返回 202、run_id 与状态查询位置;GET /v1/runs/{run_id} 需再次检查该主体对该运行的访问权限;POST /v1/runs/{run_id}:cancel 按项目需要实现。返回稳定 request_id、run_id、状态和机器可读错误,不把 provider 原始错误栈交给客户端。
验收至少有:未认证拒绝;有效身份跨租户读被拒绝;request_id 请求/响应一致;错误映射可预测;请求取消/超时不会遗留数据库事务;SSE 客户端断开后服务能取消或按明确策略继续任务。
图 1|请求入口、Agent 编排与依赖边界
4. 身份、租户、授权与限流
将身份表达为服务端构造的 Principal,而不是接受请求体里的用户/租户标识:
@dataclass(frozen=True)
class Principal:
    subject_id: str
    tenant_id: str
    scopes: frozenset[str]
    authn_method: str
认证组件验证签名、受众、有效期等后产生 Principal。领域策略再执行类似 authorize(principal, action="run:create", resource=...);读取会话或运行记录也要检查所属租户。对所有敏感对象做对象级授权测试,默认拒绝未知动作。管理员、用户和 Agent 工具的身份/权限不应混为一套共享万能凭据。
多租户 PostgreSQL 可在业务表显式存 tenant_id,所有 repository 查询均带租户条件,并将 PostgreSQL Row-Level Security (RLS) 作为纵深防御。RLS 启用后未被策略允许的行默认不可见/不可修改;表 owner 通常可绕过,superuser 与 BYPASSRLS 角色始终绕过,必要时 FORCE ROW LEVEL SECURITY;TRUNCATE 不受 RLS 限制。运行账号应是非 owner、非 superuser,并为读写策略分别验证 USING/WITH CHECK。PostgreSQL 行安全策略。连接池中绑定租户上下文时,要在每个事务设置并在结束清理,防止上个请求的上下文串到下个请求。
限流分清请求数、并发数、模型 token、工具成本、租户日预算;不能用一个“每 IP 每分钟”替代全部约束。单实例可以用本地 limiter;多个实例共享严格额度时选 Redis 原子 Lua 或网关共享限流,按已验证的 tenant_id + endpoint/cost class 分桶。Redis 官方列出 fixed/sliding window 和 token bucket,并演示 Lua 原子执行以免并发读改写竞态。Redis Rate Limiter。明确 Redis 不可用时的 fail-closed、受限降级或低风险只读策略,并测量结果;不要含糊地“自动绕过”。
租户验收:生成 A/B 两个租户;逐一测试读取、创建、更新、审批、运行状态查询、导出与取消;篡改 tenant_id、resource_id、转发头均不得改变主体权限;数据库连接池并发交错两个租户后仍不串数据;限流并发打满时无双花。
5. 模型适配器、模型路由、预算和流式输出
业务编排依赖窄接口,而不是 provider SDK 类型。模型适配器负责认证、请求映射、超时、响应解析、用量归一化、错误分类和流式事件解析;路由策略读取任务类别、数据约束、模型能力、当前配额和延迟目标,返回模型配置。初版只有一个 provider 时也保留 protocol 边界,但不要提前实现多个未经需要的 provider。
@dataclass
class ModelRequest:
    messages: list[dict]
    tools: list[dict]
    model_hint: str | None
    max_output_tokens: int
    deadline_at: datetime
    metadata: dict[str, str]  # 禁止放密钥/敏感正文

@dataclass
class ModelResponse:
    text: str | None
    tool_calls: list["ProposedToolCall"]
    finish_reason: str
    usage: dict[str, int]
    provider_request_id: str | None

class ModelClient(Protocol):
    async def complete(self, request: ModelRequest) -> ModelResponse: ...
    def stream(self, request: ModelRequest) -> AsyncIterator["ModelEvent"]: ...
适配器 contract test 应覆盖正常文本、工具调用、拒答、上下文超限、输出截断、限流、服务器错误、连接超时、流中错误和 usage 缺失。不同供应商的工具协议、终止原因、严格 schema 支持、流事件和数据保留政策并不相同;不能假设 provider 可无损互换。以 OpenAI Function Calling、Anthropic Tool Use 和 Gemini Function Calling 的当前文档逐个映射,并把供应商功能差异写入能力矩阵/ADR。外部模型的数据处理也要按实际端点与合同核对;例如厂商数据文档可能区分 abuse monitoring、应用状态与保留资格,不能笼统承诺“绝不保存”。OpenAI API 数据控制说明。
模型路由先用可解释规则,不让模型自己授权切换:例如在允许数据类别、支持工具 schema、质量基准、配额可用与预算之内选择候选;fallback 时保留原始模型错误和所用版本。只有对代表任务集做过质量/延迟/成本回归,才根据难度切换便宜或更强模型。输入/输出 token 限制、每轮调用数、工具次数、总 wall-clock deadline 和每任务预算都在应用控制,不只信任 SDK 默认重试。
一个容易漏掉的事实:LLM Gateway 的 token 预算不能单靠自身保证第三方最终账单的硬上限。流中断、供应商计费口径、并行请求、后台重试、预估 token 与结算差异均可能使应用内估算不等于最终账单。需要组合:预留/封顶应用请求、限制并发和输出、按 provider usage 对账、供应商组织/项目配额(如果可用)、账单预算告警与人工停机开关;硬上限保证须由能控制结算的供应方机制确认,不能从“我们最多传 N tokens”推断出来。
流式输出通过 SSE/WebSocket 或框架流响应传递内容/状态事件。区分 TTFT(请求到首个可见内容)、每 token 间隔/生成速度和端到端任务完成时间;流式通常改善感知等待,不意味着总任务耗时更短。工具调用的流式 JSON 是未完成数据,必须在完整事件结束、参数解析并通过 schema/权限后才可执行。客户端断开时要定义停止模型、取消工具、继续后台或保留异步运行中的哪一种。
6. 受限 Agent control loop:明确何时结束、何时交权
先实现一个 Agent 和一个受控 workflow。若流程固定,只让模型完成理解/生成步骤即可,不必自治循环;多 Agent 会增加模型调用、上下文转述、权限交接和故障路径。只有单 Agent 的能力边界/评测证明拆分有收益后再增加协调器。
参见 [Anthropic 有效 Agent 构建模式](https://www.anthropic.com/engineering/building-effective-agents) 和 [OpenAI Agents 实践指南](https://openai.com/business/guides-and-resources/a-practical-guide-to-building-ai-agents/);两者的具体框架不是必选项。控制循环应该是应用代码:
async def run_agent(run, model, tools, policy):
    while True:
        if run.deadline_expired(): return run.finish("deadline_exceeded")
        if run.steps >= run.max_steps: return run.finish("step_limit")
        if run.tokens_used >= run.max_tokens: return run.finish("token_budget_exhausted")

        reply = await model.complete(run.next_request())
        run.record_model(reply)
        if reply.finish_reason == "refusal": return run.finish("refused")
        if reply.finish_reason in {"length", "context_limit"}:
            return run.finish("model_output_incomplete")
        if not reply.tool_calls:
            return run.finish_with_answer(reply.text)

        for proposed in reply.tool_calls:
            spec = tools.get(proposed.name)
            if spec is None: return run.finish("unknown_tool")
            checked = spec.validate_json_and_schema(proposed.arguments)
            decision = policy.authorize(run.principal, spec, checked, run)
            if decision.requires_approval:
                return run.pause_for_approval(spec, checked, decision)
            result = await tools.execute(spec, checked, run.execution_context())
            run.record_tool_result(proposed.call_id, result)
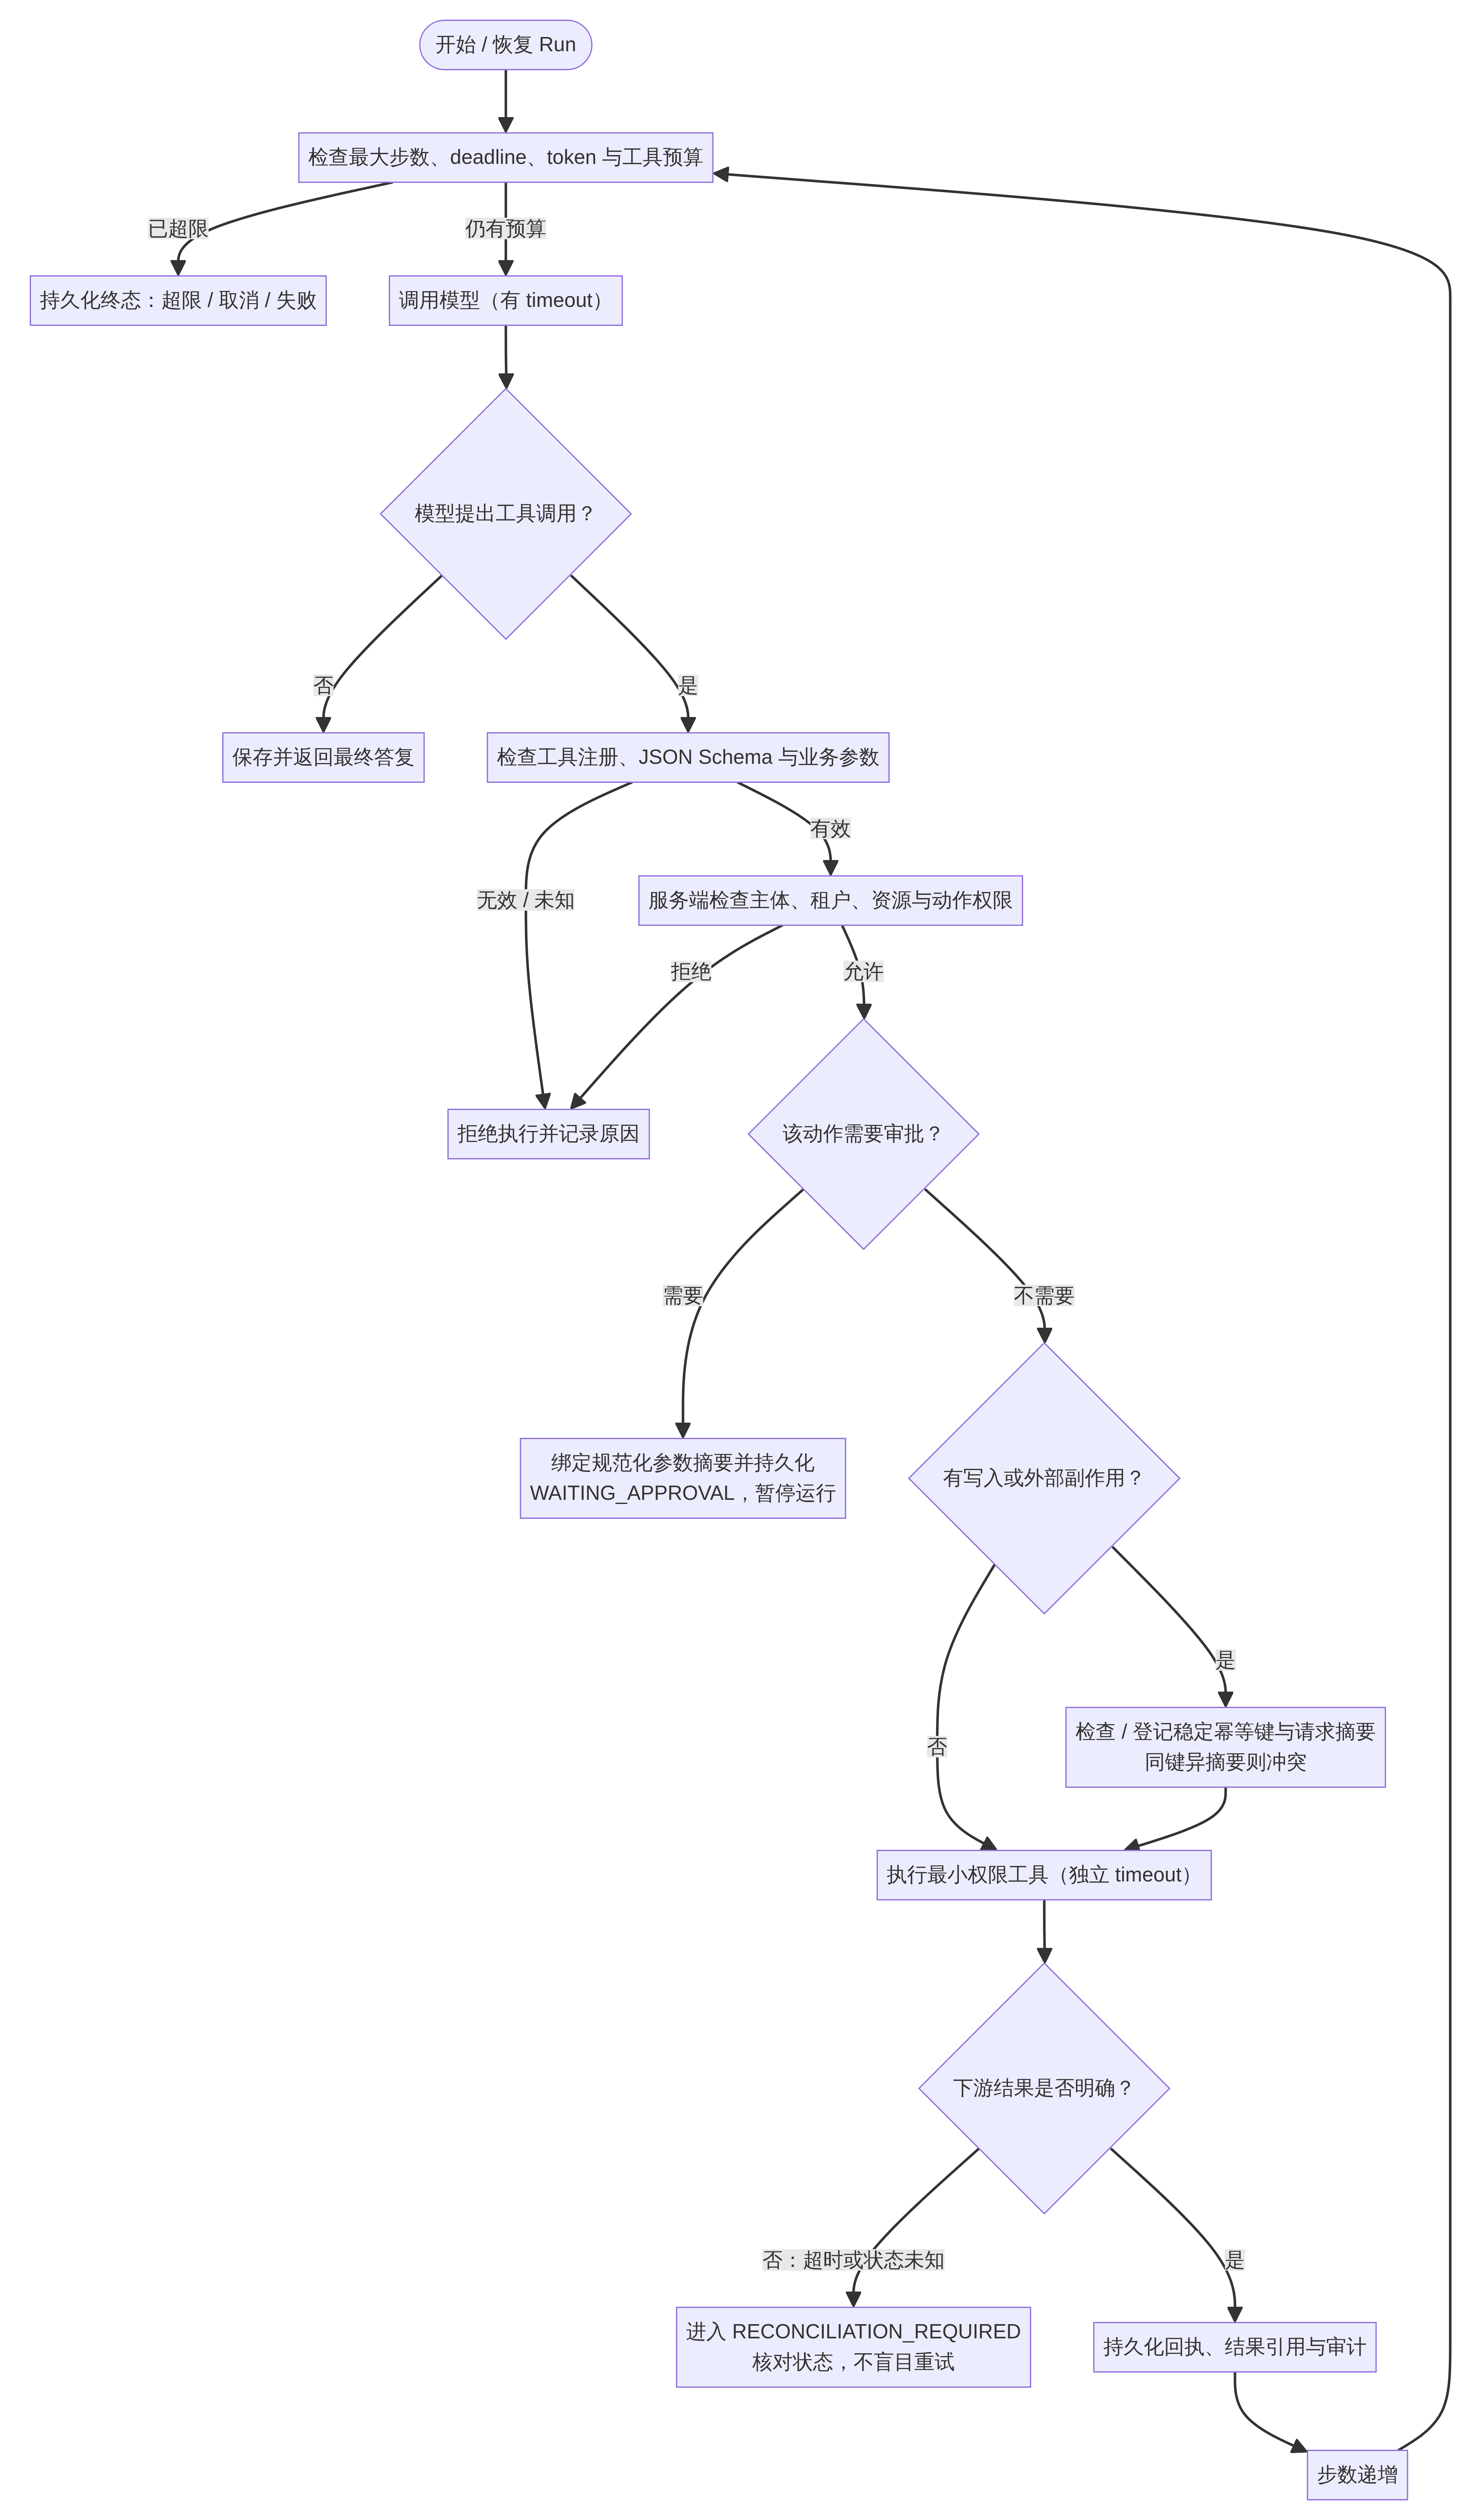
这段是示意:生产实现需将每次状态转换持久化、限制一轮内工具调用数量/并发、对每个工具独立 timeout、把取消传递下去,并处理模型并行工具调用能力差异。明确退出状态,例如 SUCCEEDED、REFUSED、TOOL_FAILED、WAITING_APPROVAL、TOKEN_BUDGET_EXHAUSTED、DEADLINE_EXCEEDED、CANCELLED。每个正常路径都要有终止条件;达到步数不等于成功,模型给出自然语言“已完成”也不等于外部 action 成功。
Agent 多次串行调用会放大延迟。端到端时间约为入口排队 + 每次模型调用/工具等待的串行和 + 重试/恢复开销;高分位会受最慢环节影响。降低模型轮数、缩短上下文、用确定性逻辑替代可预测判断,常比给模型换更快推理硬件有效。不要为了并行降低墙钟而无控制地并发写工具:并行会扩大配额峰值,且总体由最慢分支决定。
验收用假的确定性 ModelClient 回放:一次直接完成、一次工具后完成、工具参数非法、工具未授权、连续工具循环、模型 refusal、截断、超时、预算耗尽、deadline 到期、用户取消。逐项断言结束状态、模型调用数、工具调用数和审计记录。
7. 工具注册、JSON Schema、权限、副作用与幂等
工具是 Agent 实际能做什么的能力边界。每个工具尽可能窄且有稳定语义;优先 lookup_record、draft_message、submit_change,避免 run_shell、任意 SQL、任意 URL fetch 或大而全的 do_anything。结构化参数必须在服务端重新解析和校验;Schema 合法只代表形状合法,不代表此用户能对这个对象做这个动作。JSON Schema 对象字段规则说明 required 与 additionalProperties 各自控制不同事情,额外属性默认可接受;需按风险明确配置。模型工具调用资料也说明模型提出调用后由应用执行,不是模型直接获得执行权。OpenAI Function Calling。
@dataclass(frozen=True)
class ToolSpec:
    name: str
    version: str
    description: str
    input_schema: dict
    required_scopes: frozenset[str]
    side_effect: Literal["read", "draft", "write", "irreversible"]
    timeout_seconds: float
    idempotency_required: bool
    approval_policy: str | None

class ToolExecutor(Protocol):
    async def execute(
        self, spec: ToolSpec, principal: Principal,
        arguments: dict, idempotency_key: str | None,
    ) -> "ToolResult": ...
执行顺序建议:工具名注册检查,JSON 解码/schema 校验,业务语义校验(金额、目标、范围、状态),当前 principal 的动作/资源授权,side-effect/审批策略,幂等记录与下游执行,校验下游回执,保存结果与审计,回传经裁剪的工具结果。不要让模型看到或持有下游 API secret。读工具也要限制租户范围、结果条数和返回字段。
对可能产生副作用的工具分为只读、草稿、可逆写、不可逆写。重试规则由工具和错误类型决定。写工具/外部副作用不能无条件重试。网络超时意味着“结果未知”时,不能推断外部服务没有执行。应把稳定幂等键传到支持它的下游;否则使用本地唯一请求账本、先查询结果、补偿操作或人工核对状态。审批令牌应绑定主体、工具名、规范化参数摘要、目标资源和短有效期,避免批准后替换参数。
示例幂等请求账本:
{
  "tenant_id": "从已验证身份获得",
  "idempotency_key": "客户端或服务端生成的稳定随机键",
  "request_hash": "规范化请求的摘要",
  "status": "IN_PROGRESS",
  "result_ref": null,
  "created_at": "时间戳"
}
唯一约束建议落在 (tenant_id, idempotency_key)。相同 key、相同 request hash 返回已保存结果或运行状态;相同 key、不同 hash 返回冲突,不要静默覆盖。先查后插有并发竞态,应使用数据库唯一约束/原子插入处理竞争。数据库事务只保证数据库里的原子性,不会自动撤销已发出的邮件或第三方写入。
失败模式:工具名被模型编造;schema 漏 required 或允许额外字段;主体有工具 scope 但无资源权限;下游成功但响应丢失;重复执行副作用;审批后参数改变;工具结果含提示注入/秘密或过大文本。验收分别注入以上场景,断言未授权工具到不了下游、批准摘要不匹配不能执行、重复 key 只有一次副作用、工具输出被截断/净化且标记来源。
图 2|有界 Agent 运行循环与受控工具执行
8. 状态、Session、Run、检查点、长期任务与审批
把三个概念分开:会话标识多轮交互的对话上下文;运行代表一次可追踪任务;长期记忆是跨运行保留的信息,需要独立的数据治理。第一版可只保存 session 元数据、run 状态和必要的执行记录,不做长期记忆。把完整聊天历史无限追加会膨胀 token、扩大敏感数据留存,也会让旧工具结果伪装成新指令。
核心数据模型示例:
class RunStatus(StrEnum):
    PENDING = "PENDING"
    RUNNING = "RUNNING"
    WAITING_APPROVAL = "WAITING_APPROVAL"
    SUCCEEDED = "SUCCEEDED"
    FAILED = "FAILED"
    CANCELLED = "CANCELLED"

@dataclass
class AgentRun:
    id: UUID
    tenant_id: str
    session_id: UUID | None
    status: RunStatus
    version: int                 # 乐观并发控制
    step_index: int
    deadline_at: datetime
    max_steps: int
    token_budget: int
    tokens_used: int
    last_checkpoint_id: UUID | None
    result_ref: str | None
failure_code: str | None推荐表:sessions、agent_runs、run_steps、tool_invocations、approvals、idempotency_records、可选 outbox_events。每个 run step 保存类型、版本、输入/输出的脱敏引用、状态、开始/结束时间和错误类别;不要默认持久化所有完整 prompt/工具参数。Checkpoint 至少能说明当前状态、已确认完成的步骤及可安全继续所需数据;schema/prompt/tool 版本也要可追溯。
状态转换要用条件更新防止并发 worker 双推进,例如:
UPDATE agent_runs
SET status = 'RUNNING', version = version + 1, updated_at = now()
WHERE id = :run_id AND status = 'PENDING' AND version = :expected_version;
受影响行数不是 1,就表示状态已变化,应重新读取、拒绝或进入冲突处理,而非覆盖。外部写操作前持久化执行意图,回执后记录结果;无法确定结果时进入 RECONCILIATION_REQUIRED,不要伪装为成功或安全重做。
同步任务只需数据库事务和状态记录;短异步任务可用数据库队列/托管队列;要求等待审批、定时唤醒、崩溃恢复、逐步骤历史的长期工作流,可以使用 Temporal 类工作流。Temporal 官方指出 Activity 应幂等,失败会依 Retry Policy 重试,必要时 heartbeat 保存 checkpoint;Signal 是至少一次,调用方应带稳定标识去重。Temporal Activities、Temporal Workflow Execution、Temporal 修复后恢复指南。若只是简单削峰,队列通常更轻;Redis Streams 的 consumer group 有 pending 和显式 ACK,消费者失败后消息可能再次处理,不能当 exactly-once。PostgreSQL SKIP LOCKED 可用于竞争领取 queue-like 表,但不保证业务只执行一次。PostgreSQL SELECT。
审批状态不应藏在模型对话中:记录待批准的规范化动作、主体、批准策略、审批人/角色、到期时间、参数摘要、批准/拒绝结果及恢复起点。拒绝、过期、取消和批准分别有确定状态转移。审批后重新验证资源权限和条件,不能因为此前获批就忽略当前状态。
验收:进程在每个检查点前后被强杀;重新启动后任务可恢复或进入明确人工状态;模拟同一消息/审批重复到达不重复副作用;修改状态版本的并发 worker 中仅一方成功;任务查询和取消再做租户授权;敏感内容按保留策略删除/脱敏。
9. 提示词、外部内容隔离与提示注入
网页、邮件、PDF、OCR、检索片段、工具返回和用户上传均是不可信输入。提示注入既可能来自用户直接输入,也可能藏在被检索/读取的数据里;攻击结果包括越权工具、泄露信息和操纵连接系统。OWASP LLM01 Prompt Injection;NIST Generative AI Profile。把外部内容当“数据”而非“命令”,在结构中保留 source/type/content,而不是拼入 system prompt。Anthropic 建议将第三方内容放在 tool result 并显式标为不可信,且对模型输出加确定性校验。Anthropic 提示注入缓解。
防护要多层:系统指令简洁说明边界;工具权限最小化;工具参数与业务状态由代码验证;外部数据仅提供任务相关片段且限长;模型提出的动作经授权、策略和审批;结果做数据外泄检查;日志和 tracing 默认不存正文。工具输出中的字符串不能被包装成更高等级指令。输入输出过滤器有用,但不能把一个分类模型当作唯一安全边界。
每个工具采用独立下游身份和最小 scope;只读工具不要拿写权限。限制网络目的地、响应长度、文件类型、执行时长和并发。模型调用成功不代表 action 成功:只有工具下游返回可验证成功、业务状态落库且结果与请求一致,动作才可标记成功;模型说“我已完成”不是证据。
红队/回归集应包含:恶意网页让 Agent 忽略用户要求、诱骗导出凭据、在摘要里夹带工具指令、跨租户资源编号、格式对抗、工具输出含秘密、重复写操作、审批参数被替换。用工具日志与数据库最终状态断言,不只看模型答复表面是否拒绝。
10. 高可用、错误处理、重试、背压与故障恢复
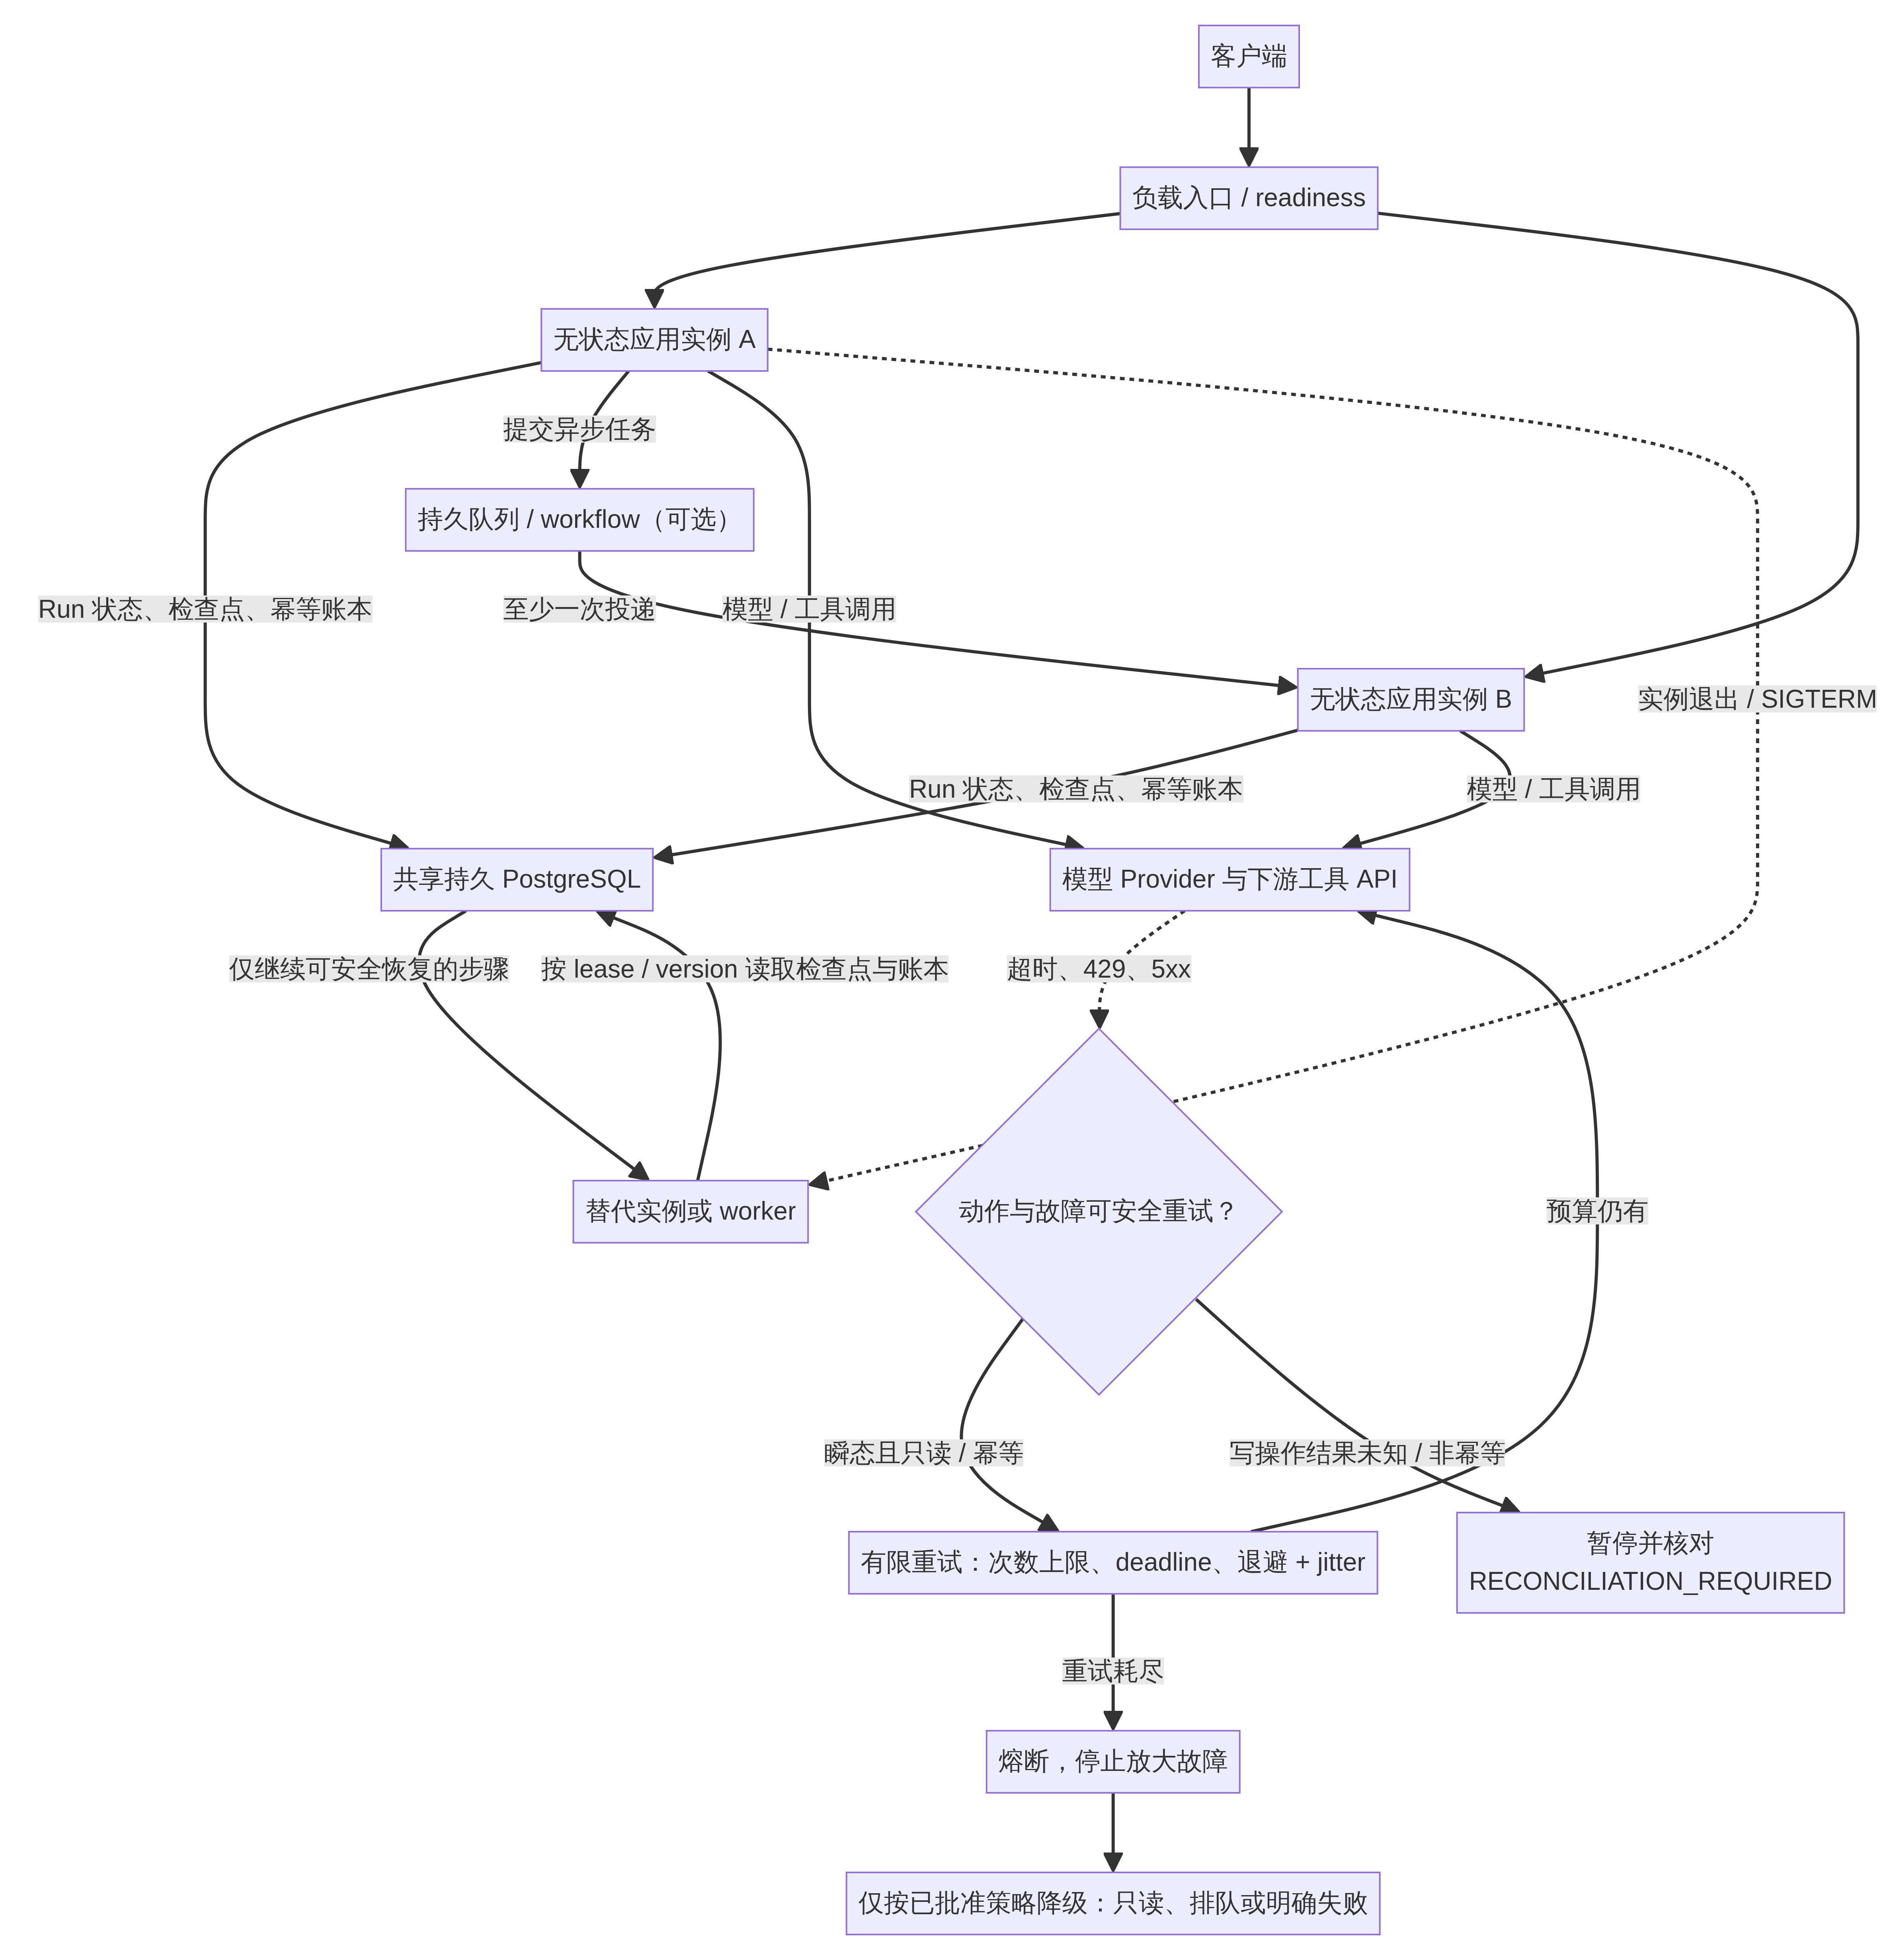
HTTP 应用尽可能无状态:跨请求状态、任务进度、幂等记录在数据库/工作流/队列中,实例可被替换。数据存储、模型供应商、队列、缓存各自的可用性与故障域要画清楚。先承诺可测的单区 SLO;只有业务 RTO/RPO、地域限制、客户可用性合同或实测故障风险要求时,才设计多区/跨区。PostgreSQL 默认异步复制在主库故障时可能丢失尚未复制的已提交事务,故障切换要对照可接受 RPO。PostgreSQL 高可用、Warm Standby。
重试是协议,不是异常处理里的装饰
对每个依赖设置连接超时、总请求超时和端到端 deadline;以错误类型决定可否重试。临时网络错误、明确限流/可重试服务错误可进行有上限的指数退避与 jitter;参数错误、未授权、业务冲突应停止。只允许一个明确的重试层,避免 SDK、HTTP 客户端、任务框架和上层 Agent 同时重试造成放大。AWS 指南强调限制重试、指数退避与随机抖动,且非幂等操作重试会产生副作用;也提醒连接和请求 timeout 必须分别配置。AWS 限制重试、AWS 客户端超时。
# 示意:总 deadline 优先;非幂等写入不因超时自动重放
for attempt in range(max_attempts):
    remaining = deadline - monotonic()
    if remaining <= 0:
        raise DeadlineExceeded()
    try:
        return await call(timeout=min(per_call_timeout, remaining))
    except RetryableReadError:
        await sleep(min(backoff(attempt) * random_jitter(), remaining))
raise DependencyUnavailable()
此伪代码只对可安全重试的读请求示意;写操作需幂等契约与未知结果核对。重试使用单调时钟而非 wall clock 计算剩余 deadline。上游取消、队列租约与 provider 超时要传播,不得任务已过期仍继续烧 token。
熔断器解决持续不可用时快速失败,不替代重试。通常有 Closed/Open/Half-Open,Half-Open 只放有限探测;熔断拒绝不应再次进入重试。Azure 的 Circuit Breaker 模式明确区分二者。并发上限/信号量限制单模型、单租户或下游同时在途工作;队列削峰需对生产速度、消费速度和过期任务做背压,不能无限扩消费者把压力转嫁数据库。Azure Queue-Based Load Leveling、AWS 松耦合。
状态与恢复策略
| 故障 | 处理边界 |
|---|---|
| provider 429/5xx | 有 deadline 的有限退避;超出配额转排队/降级/明确失败,保持模型路由可见 |
| provider timeout,尚未执行工具 | 可按适配器契约决定重试;若使用流式,先判断是否已有部分结果交付 |
| 写工具超时、下游结果未知 | 查询幂等记录/下游状态或人工核对;不要盲重发 |
| worker 崩溃、消息 pending | 使用 lease/ACK 重领;业务去重键保证重复投递安全;永久错误进死信/人工恢复 |
| 数据库不可用 | readiness 失败、不接新任务;已有任务保留可恢复状态;按目标 RTO/RPO 演练切换 |
| 持续队列堆积 | 限制入队、优先级/过期、降级或拒绝;报警队列等待与最老任务年龄 |
| 运行达到 deadline/取消 | 停止可取消的下游调用并记录清晰终态;不可取消动作进入结果核对状态 |
Redis、Kubernetes、Temporal 和多区都不是默认必要。Redis 增加新的网络依赖和可用性边界;Kubernetes 要有探针、容量、发布与值班能力;Temporal 能承载耐久 workflow,但会增加 worker、schema/versioning 与平台治理;多区涉及数据一致性、冲突和成本。每项升级都需对应具体风险和验收演练。
11. 测试、离线 eval 和生产质量指标
测试金字塔:纯单元测试覆盖状态机、策略、schema、限流预算;数据库集成测试覆盖迁移、事务、租户 RLS、幂等;HTTP 集成测试覆盖身份、错误、SSE;provider contract test 使用录制/合成响应,不让 CI 靠真实模型随机答案;端到端测试在隔离环境调用仿真工具;离线 eval 用版本化代表任务集;上线后用受控样本反馈构建回归题。
Eval case 除最终文本外,还评:任务达成、工具选择/参数、外部副作用最终状态、权限合规、停止条件、拒绝质量、成本和延迟。固定工具或数据环境用确定性断言;开放文本用 rubric 和校准的人评/模型评分;高风险安全决策不能只靠自动 judge。保存 dataset_version、grader_version、prompt/tool schema/model 版本、trace id、分数与失败原因。OpenAI 官方把 trace grading 用于评估 Agent 的决策和工具调用轨迹,并建议随后在数据集上做可重复 eval:Trace Grading、Agent Evals。这是评测实践,不要求绑定该服务商。
最低回归集包括正常样例、边界输入、空值/超长、工具 4xx/429/5xx、慢工具、连接中断、并发重复 key、审批通过/拒绝/过期、越租户访问、直接与间接提示注入、部分流、budget/deadline 触发和应用重启恢复。对每次 prompt、模型、工具 schema、授权策略和依赖升级跑回归;失败样例变成有版本的数据,不要只在 issue 里描述。
生产质量指标要分层:
- 任务质量:成功/部分成功/拒绝/人工接管率;工具调用正确率、未授权动作拦截、重复副作用数、人工抽检的正确性/依据性。
- 延迟:端到端 p50/p95/p99、TTFT、每 token latency(或 token inter-arrival)、模型等待、工具耗时、队列等待、审批等待。任务级总时长不能被 token/s 替代。
- 可靠性:HTTP 错误率、模型 429/5xx、工具失败率、重试率/次数、超时、取消、熔断拒绝、队列积压与最老任务年龄、恢复成功率。
- 成本:每个成功任务的 input/output tokens、模型/工具/重试成本、缓存收益、人工复核成本;按租户、任务类型、版本汇总,和供应商账单核对。
- 资源:应用 CPU/内存/连接池、DB 查询/锁等待、worker 并发、provider 配额使用率。设置 warning/critical 门槛需依据业务 SLO 和压测基线确定。
仅测模型 token/s 不够。例如一个任务串行经过 3 次模型调用和 2 个工具,任务 p95 取决于各段排队、网络、工具与重试,且相关尾延迟不能简单用平均值相加推断。必须用真实任务形态的 end-to-end 压测同时采集分位数、调用次数、token 分布和成功率。
12. 日志、traces、metrics 与 OpenTelemetry
以 request_id、run_id、tenant_pseudonym、model/provider、prompt_version、tool_name/version、结束状态、耗时、重试次数和 token usage 建立结构化日志与 trace 关联。一次 run 作为 root span;子 span 覆盖入口、排队、每次模型调用、工具执行、审批、数据库事务和回退。HTTP/队列跨服务传播 trace context;OpenTelemetry 描述 span 层级和 context propagation 可关联跨进程操作,默认使用 W3C Trace Context。OTel Traces、Context Propagation。异步新任务可用 link 表示因果关系,避免伪造不成立的直接父子关系。
Metrics 放低基数维度:任务类型、状态、provider、工具名、错误类别。不要把 user_id、run_id、原始 URL、prompt hash 作为无限 label;单次诊断放 span/log。指标适合聚合计数和分布,traces 用于定位单次执行;OTel Metrics特别提醒高基数会影响成本/存储。GenAI semantic conventions 仍需按选用版本核对;不要将不断演进的字段当成所有 provider 的稳定保证。OTel GenAI 语义约定仓库。
提示词、模型输入输出、tool args/result 可能包含个人资料、凭证与机密。默认采集元数据和脱敏摘要,按字段白名单;如必须采样原文,应有明确目的、授权、保留期限、访问权限和删除机制。SDK 自身无法判断你数据是否敏感;OTel 官方建议最小化采集,并可在 Collector 通过 filter/attributes/redaction/transform processor 删除或变换数据。OTel 敏感数据处理。测试要在最终 exporter/Collector 输出中搜索模拟邮箱、密钥与外部内容,确认没有绕过脱敏。
13. 性能、容量与预算:按任务估算、用压测校准
先取得一个真实但去敏的任务样本分布:每任务模型轮数、输入/输出 tokens、工具数与耗时、是否重试、是否流式、并发与到达率。粗略并发可从 Little 定律 在途数 ≈ 到达率 × 平均驻留时间 估起,但要用压测的 p95/p99 与下游配额校准。容量不是“多加副本”就无限增长:provider TPM/RPM、数据库连接、工具 API 和队列消费者都有各自上限。
推荐压测报告每个负载档位:到达率、活动 run 数、每任务模型/工具调用数、端到端 p50/p95/p99、TTFT、token latency、队列等待、模型/工具错误与 429、DB 连接池利用、CPU/内存、tokens/成本/成功任务。压测使用隔离写工具或模拟器,避免制造真实业务副作用;对超时和重试设置硬边界。
成本估算按每个成功任务而非仅按请求计:输入 tokens × 当前价格 + 输出 tokens × 当前价格 + 重试/工具/检索/日志/运行环境 + 必要人工复核。将价格、模型可用区、配额和数据处理条款视为动态信息,上线前从供应商当前官方页面/账户配额核验并记录时间。不要把预估 token 当到账单上限。缓存只应用于可安全共享且版本/租户边界清楚的数据;避免缓存敏感响应、授权决策或跨租户内容。
14. 部署、发布、监控告警与运行手册
容器镜像固定依赖和基础镜像版本,使用非 root 用户、只读文件系统(若应用兼容)、health endpoint、资源限制和 secret 注入;本地 Compose 可验证依赖启动顺序,但 Compose 默认只等待容器 running,不等 ready,需通过 healthcheck/service_healthy 表达就绪条件。Docker Compose 启动顺序。
健康检查区分:/livez 仅判断进程还能工作;/readyz 检查接受新请求所必需的依赖。Kubernetes readiness 失败会移除服务流量,liveness 失败会重启容器,错误的 liveness 在依赖故障时可能引发重启风暴;startup probe 保护慢启动。Kubernetes Probes。不上 Kubernetes 也应在平台能力中实现等价行为。优雅关闭接 SIGTERM 后先停止接新任务、设为 unready,再在 deadline 内排空任务/关闭连接;超出 deadline 的长任务必须能恢复。
发布使用不可变镜像 digest;DB migration 需采用向后兼容的 expand/contract:先加列/双读写,部署兼容版本,迁移数据,再移除旧结构。不要先发布只认识新 schema 的应用、再指望回滚兼容。渐进发布适用于能独立监控新旧版本且有回滚目标的场景。Kubernetes Deployment 会报告 rollout 超时,但不会自行完成业务回滚;revision history 被清理后不能 undo。Kubernetes Deployment。先在预发布演练应用版本、prompt/model 路由变更、工具权限和 migration 回滚。
最小值班 Runbook 模板
- 告警名称与用户影响:例如任务 p99 超 SLO / 写工具状态不确定 / 队列最老任务过期。
- 先看什么:Dashboard 链接、当前版本/digest、模型与工具版本、近期发布和依赖状态。
- 安全止损:限流入站、暂停某类工具、切只读/排队、关闭有风险的路由;写清谁有权做及影响。
- 诊断顺序:按 request/run trace 查任务级耗时;拆 provider、queue、tool、DB;避免先重放不明副作用任务。
- 恢复/回滚:执行准确命令或控制台路径、触发条件、回滚目标、migration 兼容性。
- 验证恢复:端到端合成请求、错误率/队列/延迟恢复、无重复写;恢复后逐步解除限流。
- 事后证据:时间线、受影响任务、重复/漏执行核对、原因、回归测试、改进责任人与期限。
关键告警要包括:任务成功率、端到端 p95/p99、TTFT、模型错误/429、工具错误、审批积压、队列深度和最老任务、重试风暴、幂等冲突、DB 连接池和复制延迟、单位成功任务成本超预算、trace exporter 错误。只设 CPU 告警会漏掉配额饱和或下游变慢。
图 3|无状态实例、持久恢复与依赖故障降级
15. 给编程 Agent 的分阶段复制粘贴提示词
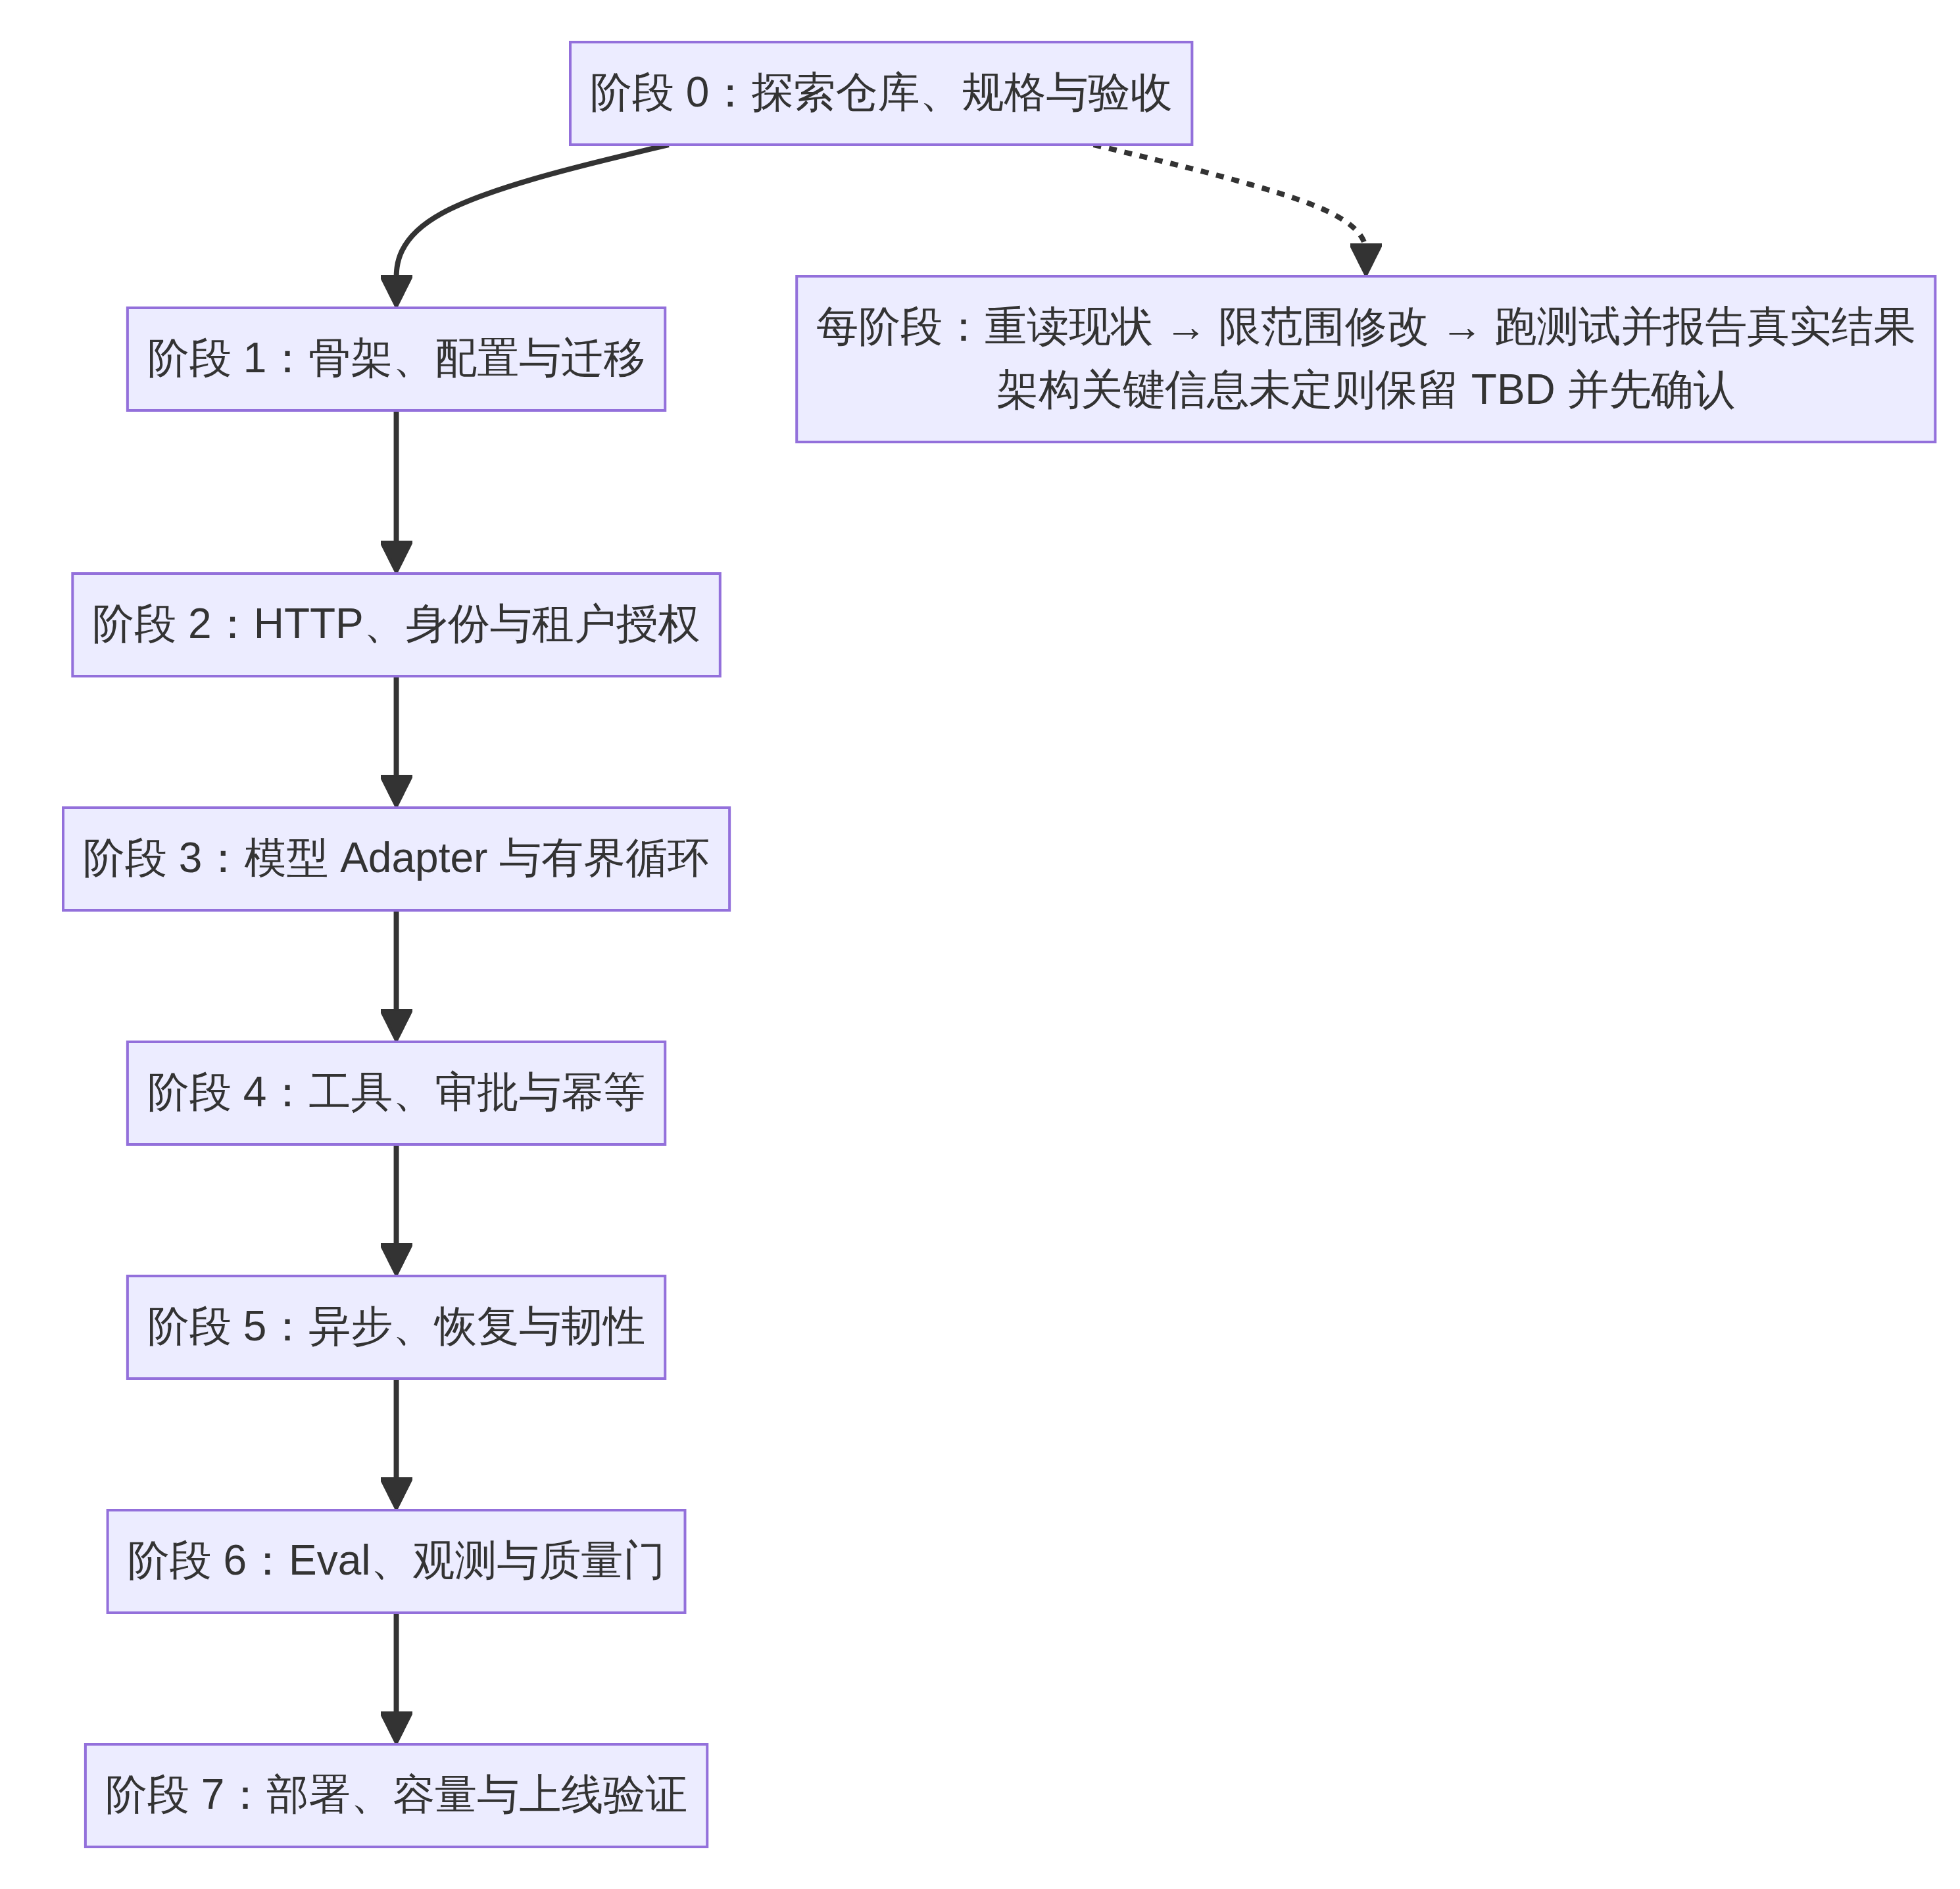
先提供业务 brief;再按阶段逐条发提示,不要用一个巨型 prompt 要求一次搭完。每个阶段都要求 Agent 重新读取现有项目、仅局部修改、跑测试并报告;测试没通过时先修复或报告阻塞,不能假称完成。把尖括号占位符替换为实际信息;未提供的事实保留 TBD 并询问,不得脑补。
图 4|编程 Agent 分阶段实施路径
通用前缀(每阶段可附在提示词末尾)
通用执行约束:
1) 先检查当前分支、工作区变更、目录结构、项目说明、依赖锁文件、已有测试和运行入口;不得覆盖用户未提交改动。每次阶段开始都重新读取相关文件,不要假设前一阶段代码仍完全相同。
2) 仅修改本阶段“允许改动范围”内文件。确需越界时先解释原因和影响,并暂停等待我决定;不要顺手重构无关模块、升级全仓依赖或新增云服务。
3) 尊重仓库已有技术栈;本项目技术选择以 spec.md 和 ADR 为准。未确定项标 TBD,不替用户编造业务规则、权限、预算、SLO、provider、云厂商或数据保留政策。
4) 对任何模型输出、工具参数和外部数据都按不可信输入处理。业务授权在服务端执行;任何写/外部副作用在确认幂等、审批和状态语义之前不得自动重试。
5) 添加/修改测试,执行本阶段列出的命令及受影响的相关测试。若环境缺依赖/服务,报告精确命令、错误和未验证范围;不伪造通过。
6) 完成后报告:改动文件及目的、关键接口/决策、运行的测试命令与真实结果、未解决问题/风险、下一阶段前需要我确认的架构变量。不要把密钥、完整个人数据或敏感 prompt 写入代码/测试日志。
阶段 0:先探索需求和现有仓库,只问影响架构的缺项
目标:在不编写应用代码的前提下,探索现有仓库和业务需求,输出可审阅的项目 spec、ADR 草案和验收计划。

允许改动范围:仅新增/修改 docs/spec.md、docs/adr/*.md、docs/acceptance-plan.md;不改应用代码、依赖、基础设施或数据库。

步骤:
- 读取仓库说明、目录、现有 API/数据模型/认证、CI、测试、部署配置与未提交变更;先总结已有资产和限制。
- 使用下方项目 brief。缺项只问会改变组件选择、数据权限、外部动作风险、同步/异步、恢复语义、部署或 SLO 的问题。对不影响架构的文案/小默认,记录假设,不反复追问。
- 输出 spec:目标/非目标、用户/身份、输入输出与数据分类、允许和禁止动作、审批点、失败状态、同步/异步、SLO/预算、部署约束、验收样例;未知写 TBD 并标出责任人。
- 输出 ADR:至少记录当前栈沿用方案、是否需要 Redis/队列/持久工作流/独立 Gateway/多区及理由;没有证据就列为不引入,不假设云厂商。
- 输出 acceptance-plan:功能、权限/安全、注入、幂等/恢复、性能、观测/发布验收,指出哪些阈值尚待确认。
- 不要编造业务需求或声称测试已经执行。

验收命令:如仅编辑 Markdown,运行仓库已有文档 lint;若没有,检查链接/代码围栏和 Markdown 格式,并报告命令。提交前展示核心未决问题列表并等待确认后再进入阶段 1。
阶段 1:项目骨架、配置、环境和数据库迁移
目标:建立或整理最小可运行项目骨架,配置本地开发环境、健康端点及可审阅的数据库迁移,不实现 Agent 行为。

先读取:spec.md、ADR、依赖锁、现有 app 入口、DB session、迁移脚本、CI 与测试。
允许改动范围:pyproject/锁文件(仅最小必要依赖)、.env.example、.gitignore、app/config.py、app/main.py、app/db/*、alembic/*、tests/unit 或 tests/integration 中骨架测试;不得加具体业务表/工具,除非 spec 明确要求。

代码接口:提供 Settings(集中环境配置、测试可覆盖);FastAPI app factory;DB session 生命周期依赖;Alembic 从同一配置取 URL。健康端点定义 `/livez` 与 `/readyz`,不得把真实凭据放默认值。

实现要求:不在请求期间读取配置文件;不在应用启动自动运行不可逆 migration;session 有明确关闭/rollback;提交 migration 前说明 schema 影响和 downgrade 限制。

测试命令:`<项目安装命令>`、`<lint 命令>`、`<单测命令>`、`<临时 PostgreSQL 集成测试命令>`、`<alembic upgrade head 验证命令>`。

验收:干净环境可按 README 重建;配置缺失能清楚失败;health 端点正确;迁移能在空临时库 upgrade;无真实 secret/venv 进版本库。完成后报告改动与实际命令结果。
阶段 2:HTTP 入口、身份、租户授权与错误契约
目标:实现 spec 明确要求的最小 HTTP API、安全身份上下文和服务端授权,不连接真实模型或执行外部副作用。

先读取:现有 API、middleware 顺序、身份来源、Principal、租户表/RLS 策略、spec 中权限矩阵及用户未提交变更。
允许改动范围:app/api/*、app/dependencies.py、app/domain/policies.py、现有身份/租户表 migration、对应 API/security 测试;不得添加新 Gateway/认证提供商或变更授权规则,除非 spec 已明确。

接口:实现 `<API 路径>` 与稳定错误 schema;Principal 由已验证身份创建;对每个资源动作调用显式 authorize;`request_id` 贯穿响应/日志;trusted proxy 仅按配置网段信任。Gateway 认证不能替代资源级授权。

测试命令:`<lint>`、`<unit>`、`<API integration>`、`<跨租户权限矩阵测试>`。

验收:未认证/越权/错误租户均拒绝;路由、状态码、错误体和 request_id 稳定;RLS(若 spec 采用)用应用运行角色验证读写和连接池交错;middleware 顺序固定;没有从请求体采信 tenant_id。遇到身份来源或权限矩阵缺项时暂停并提问,不自行补全。
阶段 3:模型 Adapter 与受限 Agent loop
目标:实现 provider 中立的 ModelClient、一个已批准 provider adapter 和有界单 Agent 控制循环;无真实业务工具副作用。

先读取:spec/ADR 的 provider、数据条款、模型预算、deadline、工具协议;现有配置、HTTP timeout、日志脱敏、测试替身。
允许改动范围:app/llm/*、app/agent/loop.py、agent schemas、相应 contract/unit tests 和最小依赖锁变更;不改领域权限或部署架构,不增加第二 provider/多 Agent。

接口:ModelClient.complete/stream;统一 ModelRequest/Response/Usage/FinishReason;AgentRun 预算含最大步数、工具数、token、wall-clock deadline;显式处理拒答、截断、超时、错误、取消、无工具完成、预算耗尽。

要求:provider 字段只存在 adapter 内;记录模型/提示版本和用量而不记录敏感正文;工具参数的流式增量不得在完成/schema 验证前执行;任何 SDK 内外重试的总上限可解释。

测试命令:`<lint>`、`<unit>`、`<provider adapter contract tests>`;仅用 fixture/mock,不调用真实生产工具。

验收:fake model 覆盖正常结束、拒绝、截断、工具提议、provider 429/5xx/timeout、stream 中断、连续循环;每种都断言调用次数、结束原因和预算;provider 数据保留/区域限制未确定时明确标 TBD。
阶段 4:工具注册、业务状态、幂等和审批
目标:实现 spec 批准的少量工具、JSON Schema 校验、服务端授权、工具调用记录、幂等及审批状态(仅在需求确实存在时)。

先读取:ToolSpec/Principal/AgentRun 接口、数据分类、风险矩阵、下游 API 文档、幂等能力、审批规则、数据库迁移及状态机。
允许改动范围:app/tools/*、app/domain/* 中必要策略、app/db/* repository、相关 migration 和 tests;不得增加 spec 未授权工具、shell/任意 SQL、额外 scope 或真实高风险动作。

接口:ToolSpec 含 name/version/schema/required_scopes/side_effect/timeout/idempotency_required/approval_policy;ToolExecutor 统一先校验 schema、语义、资源授权,再审批/执行;写动作持久化 idempotency key 与 request hash。相同 key 不同摘要返回冲突。

要求:unknown tool 拒绝;额外字段按 schema 策略拒绝;工具输出视为不可信;未知下游执行结果进入可核对状态;模型声称成功不能替代工具回执。

测试命令:`<lint>`、`<unit>`、`<临时数据库 integration>`、`<模拟下游 contract/security tests>`。

验收:跨租户、错 scope、错误参数、审批缺失/过期/参数不符均无下游副作用;相同幂等请求不重复执行;唯一约束并发测试只有一个结果;所有工具有超时与错误分类;实际写工具先使用 mock/sandbox,用户未批准前不得触达生产数据。
阶段 5:耐故障、异步队列/工作流与网关边界
目标:依据已批准的任务时长和恢复需求,补上必要的异步/耐久执行、超时、有限重试、并发限制、熔断、背压和部署边界;如同步方案足够则保持简单并在 ADR 说明。

先读取:任务 deadline、SLO/RTO/RPO、既有队列/平台能力、所有下游幂等语义、provider retry、部署拓扑。不得仅因“生产级”添加 Redis/Kubernetes/Temporal/多区。
允许改动范围:app/jobs/*、有批准的 queue/workflow adapter、依赖 client resilience、ADR、故障恢复测试;不得更改业务动作语义。

接口:Run 状态可持久查询/取消;worker 使用 lease/version;任务消息包含稳定 event_id/run_id;退避使用上限+jitter;熔断拒绝不再重试;可测 readiness/liveness;明确 API Gateway 与 LLM Gateway 各自职责。

测试命令:`<单测>`、`<integration>`、`<worker restart/duplicate delivery tests>`、`<故障注入命令>`。

验收:重启/重复投递/下游超时后可安全恢复;写副作用只发生一次或进入人工核对;最大在途/队列容量/最老任务告警可观测;恢复演练有真实证据;自动回滚目标存在。若队列/工作流提供至少一次语义,必须以应用幂等处理,不宣称 exactly-once。
阶段 6:离线 eval、结构化观测与质量门
目标:建立版本化评测集、工具/业务状态评分、OpenTelemetry traces/metrics/logs 与脱敏检查,形成发布前质量门。

先读取:现有日志字段、数据保留分类、敏感字段列表、trace exporter/collector、eval 样例、SLO/成本口径。
允许改动范围:tests/evals/*、app/observability/*、必要仪表化、docs/evals.md、脱敏 Collector 配置;不得默认导出完整 prompt/tool payload,不得引入个人信息作为 metric label。

接口:root run span + model/tool/approval spans;run_id/request_id 关联;metrics 使用低基数属性;eval case 保存 dataset/model/prompt/tool/grader 版本、trace 关联和业务结果。区分 operation status 与 quality score。

测试命令:`<eval runner>`、`<OTel exporter integration>`、`<PII/secret redaction tests>`、`<metrics cardinality test>`。

验收:固定数据集可重跑比较;覆盖权限、注入、工具失败、超时、预算、重复副作用;导出的 OTLP 内容中不存在测试邮箱/API key/敏感原文;仪表盘能分解端到端 p95/p99、TTFT、队列等待、工具与模型错误、每成功任务成本。门槛由 spec 或责任人确认,未确认写 TBD。
阶段 7:部署、发布、容量与 Production Readiness 验证
目标:完成可重复构建的容器部署配置、健康/优雅关闭、迁移发布策略、容量测试、告警/Runbook 与回滚演练。

先读取:用户实际部署目标、网络/密钥/区域约束、migration、镜像构建、CI/CD、SLO/RTO/RPO、provider 配额和数据政策。部署目标未确定时只完善 provider-neutral 容器和本地 Compose,不新增云资源。
允许改动范围:Dockerfile、compose 或已批准平台 manifests、CI pipeline、docs/runbooks/*、容量/e2e tests;不改 Agent 权限、业务动作或真实生产资源。

接口:`/livez` 与 `/readyz` 分离;SIGTERM 停止接收新任务并有界排空;镜像使用 digest;数据库采用兼容 migration;发布失败可回到保留的已知版本;告警含 run-level latency、provider/queue/tool、数据库及预算。

测试命令:`<lint/test suite>`、`<容器构建扫描>`、`<迁移 upgrade/rollback compatibility>`、`<staging smoke>`、`<负载测试>`、`<回滚演练命令>`。

验收:干净环境能部署;探针语义正确;SLO 在代表性端到端负载达到;成本用实际 provider usage/官方现价核算;断开下游/发坏版本能触发可执行 Runbook;演练记录 RTO/RPO、失败任务与副作用核对。没有 staging、配额或发布权限时,明确标未验证,不冒称 Production Ready。
16. 人类应提供的项目 brief 模板
复制并填入;无法确定的项目写 TBD。具体动作、权限和数据政策缺失时,编程 Agent 应先问而不是自行发明。
# 项目 Brief

## 目标
- 要帮助用户完成什么:<填写>
- 成功结果如何判定:<填写,可验证业务状态>
- 非目标/禁止事项:<填写>

## 用户、身份与边界
- 用户/租户类型:<填写>
- 身份验证来源和 principal 字段:<填写/TBD>
- 资源归属、角色、scope、租户隔离要求:<填写/TBD>

## 数据分类
- 用户输入、外部文档、工具结果包含:<公开/内部/个人/敏感/其他>
- 是否可发送到外部模型、允许区域/provider:<填写/TBD>
- 日志/trace/会话/长期记忆的保留和删除要求:<填写/TBD>

## 允许的工具和动作
- 允许工具及参数范围:<逐个列出>
- 禁止工具/动作/目的地:<填写>
- 写操作、不可逆操作与下游幂等支持:<填写/TBD>
- 哪些动作需要谁批准、批准绑定哪些信息:<填写/TBD>

## 任务与状态
- 典型输入/输出样例(脱敏):<填写>
- 同步还是后台;最长运行时间:<填写/TBD>
- 取消、重试、未知副作用、人工恢复规则:<填写/TBD>

## SLO 与预算
- 端到端成功率及 p95/p99:<填写/TBD>
- TTFT 或流式体验要求:<填写/TBD>
- 峰值到达率、并发、任务量:<填写/TBD>
- 单任务/日/月模型及基础设施预算:<填写/TBD>
- RTO/RPO:<填写/TBD>

## 技术和部署约束
- 当前仓库/技术栈/已有服务:<填写>
- 部署平台、网络、密钥管理、区域:<填写/TBD>
- 依赖必须沿用或不得引入的组件:<填写>
- CI、测试、发布、回滚权限:<填写/TBD>

## 验收样例与责任人
- 正常成功用例:<填写>
- 权限拒绝/提示注入用例:<填写>
- provider/工具/数据库故障用例:<填写>
- 发布门槛批准人、风险接受人、值班联系人:<填写/TBD>
17. Production Readiness Gate Checklist
生产发布前逐项打勾并附证据链接/测试输出;“计划以后补”不等于通过。对不适用项写理由;SLO、保留期和安全例外应由有权责任人接受。
需求与范围
-
目标、非目标、用户、数据类别、允许/禁止动作、审批点已由业务负责人确认。
-
所有 TBD 的架构影响项已关闭,或有责任人/截止时间/风险接受记录。
-
每条关键要求都有可重复的验收样例和业务状态断言。
安全与权限
-
身份校验与资源级授权分离;每个请求/工具调用服务端检查主体、租户、资源和动作。
-
默认拒绝;跨租户/越权/角色不足回归通过;DB runtime role 无 owner/superuser/BYPASSRLS 能力。
-
工具 schema、语义、结果长度、网络目的地、scope 和下游凭据按最小权限配置。
-
直接/间接提示注入与恶意工具结果回归通过;外部文本明确作为不可信数据。
-
高风险动作审批绑定主体、参数摘要、目标和时效;拒绝/过期/取消路径可测试。
-
敏感信息不会出现在普通日志、metric label、trace 或错误响应;有保留和删除策略。
Agent 行为与副作用
-
单 Agent/workflow 已足以满足需求;每个 run 有步数、工具次数、token、并发、deadline 和取消边界。
-
每种结束原因明确;模型 refusal/截断/工具失败不会伪装成成功。
-
所有副作用有稳定幂等策略、结果核对或人工补偿路径;不存在未知结果时无条件重试。
-
重复请求、重复消息、worker 重启和审批重复信号测试通过。
-
checkpoint 含版本化恢复所需状态;真实业务副作用和数据库状态不会出现未处理的不一致窗口。
可靠性与容量
-
依赖连接/请求 timeout、端到端 deadline、有限退避+jitter、熔断、并发限制均经过故障注入。
-
无多层重试风暴;队列有界、过期/DLQ/背压策略明确;任务等待时间可观测。
-
多实例应用无本地权威状态;连接池、Redis/队列/数据库、模型配额与下游限制均测过。
-
代表性任务端到端压测满足已批准的吞吐、p95/p99、TTFT、错误率与单位成功任务成本。
-
若宣称高可用,已按目标 RTO/RPO 完成存储/队列故障切换演练;多区不是仅画在图上的承诺。
测试、评测与观测
-
单元、DB/API 集成、provider contract、安全回归与版本化离线 eval 均通过。
-
Eval 覆盖实际业务成功状态、工具轨迹、拒绝、安全、成本和延迟;评测基线可复现。
-
trace 可从 request/run 关联到模型、工具、审批、重试、数据库/队列关键步骤。
-
dashboard 与告警覆盖任务级 p95/p99、TTFT、模型/工具错误、队列等待、预算、重试、幂等冲突和 DB 健康。
-
exporter 最终输出经过敏感数据测试;metrics 标签低基数。
发布、回滚与运营
-
镜像/依赖/模型/提示/工具 schema/策略版本可追踪,secret 与环境隔离。
-
Migration 采用兼容发布步骤并在临时数据库验证;应用回滚不会破坏已迁移数据。
-
健康检查、优雅关闭、在途任务排空/恢复已实测。
-
发布失败有已验证回滚目标;没有把平台“rollout failed”误当作自动完成业务回滚。
-
Runbook、值班路径、止损开关、下游状态核对和事后复盘模板可由值班者执行。
-
真实生产写入、用户通知或不可逆动作仅在授权边界内启用,并有业务负责人批准的演练/灰度计划。
18. 判断复杂度的最后一条工程原则
不要按组件数量判断成熟度,按可验证的边界判断:谁有权调用什么、哪一步产生副作用、失败后如何知道做没做、需要保存什么才能恢复、用户如何看到真实状态、怎么证明质量和成本达标。先交付一个能在安全边界内完成任务、能停止、能说明失败、能重放测试的单 Agent;再由真实指标和风险推动 Redis、持久工作流、多模型网关、Kubernetes 或多区。这样编程 Agent 写出来的才是一个可运行、可验收、可运维的项目,而不是一张架构图的代码化外壳。