多 Harness 强化学习终极指南(全文翻译)
2026-10-01,Hugging Face 放出多 harness 强化学习指南。小模型在四个 harness 里一起训练,留出任务解决率从 42% 升到 54%。
2026-10-03 · 最新速递
本文挂在 最新速递。
原文:The ultimate guide to multi-harness RL。作者:Adithya S Kolavi、Joel Niklaus、Sergio Paniego Blanco、Leonie Monigatti、Amine Dirhoussi、Ben Burtenshaw、Lewis Tunstall、Leandro von Werra(Hugging Face、Liquid AI)。发布时间:2026 年 10 月 1 日。本译文为全文翻译,标题层级与原文对应。
同一个模型在每个 agent harness 里表现都不一样。现在你可以用强化学习,在人们实际使用的 harness(如 Claude Code 和 Codex)内部训练它,并让它在所有这些 harness 里同时变强。
01 · 导言
如果你用 AI 写代码,你很可能通过不止一种工具使用过同一个模型:Claude 模型用在 Claude Code、Cursor、Pi 或 Cline 里。你或许已经注意到,它在每个工具里的行为并不相同。它的规划方式不同,调用的工具不同,在某个工具里能完成的任务在另一个工具里却卡住。
这种差异是可以测量的,它来自包裹在模型外围的那段程序,称为 agent harness。harness 负责运行循环、决定模型拿到哪些工具、编写模型读取的上下文、理解模型返回的内容,并决定何时停止。换一个 harness,就改变了模型看到什么、被允许做什么,结果自然不同。在 SWE-bench Pro 上,Joel Niklaus 测出同一个模型 GLM-5.2 在一个 harness 里是 23%,在另一个里是 52%。排名也不会在模型之间延续:对 GLM-5.2 来说 Codex 是十个 harness 中的第二,对 Gemma 4 26B-A4B 来说却是第九。
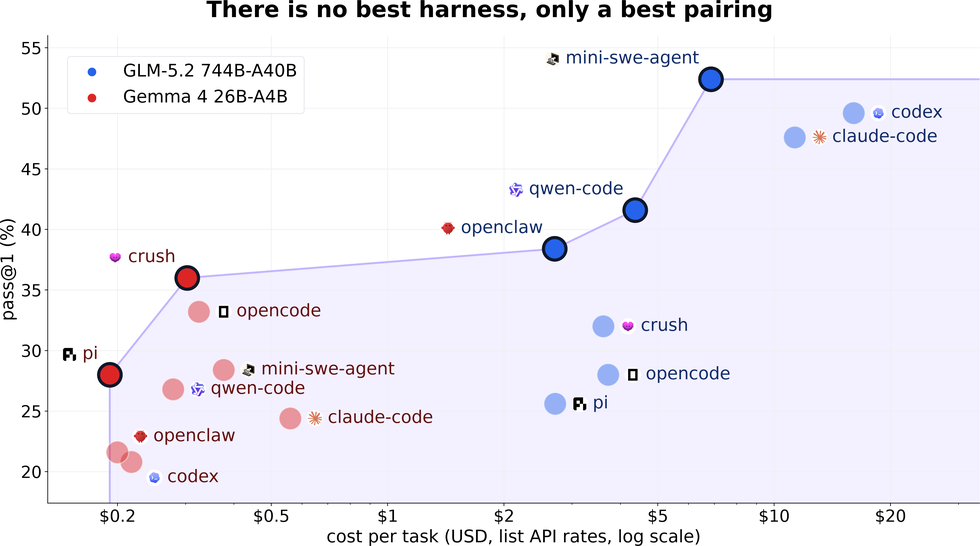
图 1| 两个模型在 SWE-bench Pro 上换 harness。横轴是单任务成本,纵轴是 Pass@1。同一个模型,点会散开。
harness 对你自己运行的开源权重模型影响最大。一个从未在你的 harness 里训练过的模型可能在这里表现挣扎:它调用 harness 没有的工具,或写出 harness 读不懂的输出。只在某一个 harness 里训练也解决不了问题,因为那样它学到的只是那一个 harness 的习惯,换到其他 harness 仍然吃力。
解法是在 harness 内部训练模型本身,用强化学习训练多步工具使用,这称为 agentic reinforcement learning(智能体强化学习,agentic RL)。这项工作要回答的问题是:能否拿一个小型开源模型,在人们实际使用的 harness(如 Claude Code、Codex 和 OpenCode)内部这样训练,并让它在这所有 harness 上都得到提升。这些 harness 完全按原样运行。没有一个是带着训练目的写的,我们也不改它们的代码。本文介绍一个让这成为可能的开源框架,它基于 OpenEnv 构建,由 Harbor 提供任务和沙箱,TRL 担任训练器。
文章分两部分。第一部分是指南:harness、agentic RL 和 RL 环境的基础,然后结合近期论文与模型报告,说明模型为什么需要跨 harness 训练。第二部分是我们自己的工作:框架如何工作,以及我们用它在四个 harness 上同时训练一个小型开源模型 LFM2.5-2.6B 时发生了什么。跨全部四个 harness 训练后,它在四个 harness 上的留出任务解决率从 42% 提升到 54%,并且在它原本就能解决的任务上工具调用减少了 31%。只在 OpenCode 里训练的同一个模型,主要只在 OpenCode 上提升,在从未训练过的三个 harness 上提升小得多。我们还把 RL 与在更大模型的成功 rollout 上做监督微调(SFT)做了对比,后者帮助更小。我们更早用 Qwen3.5-2B 做的运行放在训练章节的可折叠小节里。
02 · 基础
2.1 什么是 harness?
一篇 2026 年关于基准披露的立场论文把 agent harness 定义为:模型与任务之间的软件层,它构造模型看到的上下文、调解模型的工具调用、校验模型的输出,并决定何时重试、升级或停止(Zhang et al., 2026)。对模型来说,harness 是它通往任务的接口。对训练器来说,harness 是别人写好的程序,训练器无法改动。
有几个相近术语容易混淆,本文按以下方式使用它们:
- 策略(policy) 是正在被训练的模型:把提示变成补全的权重,调用之间没有循环、没有记忆。本文也称它为模型。
- 智能体(agent) 是运行在 harness 内的策略,是完整程序:规划、调用工具、决定何时停止。
- 沙箱(sandbox) 是动作真正执行的隔离场所,例如容器、虚拟机或 tmux 会话。
- 基准(benchmark) 是固定的任务集,外加一套在它上面比较结果的协议。
Hugging Face 的 agent 术语表对这些术语有更详细的说明。
模型选择工具及其参数。harness 执行这次调用,并在询问模型下一步做什么之前把结果加回模型的上下文。
下图把训练循环(采样、打分、更新)放在它作用的环境旁边。
2.2 白盒与黑盒 RL 环境
到底是谁在驱动 rollout?
在白盒环境中,训练器拥有循环。训练器采样一个动作、调用 env.step()、读取观察,然后再次采样。环境等待被调用。策略产生的每一个 token 都已在训练器手里,因为正是训练器采样了它们。先前指南中比较的全部六个框架都是这么工作的,这也是你把环境工厂交给 TRL 的 GRPOTrainer 时它期望的方式。
在黑盒环境中,harness 拥有循环。它在沙箱内启动,运行自己的循环,调用自己的工具,压缩自己的上下文,并在自己决定的时候停止。它是一个从未以训练为目的编写的智能体程序。训练器在那个盒子外面,它只能看到到达模型端点的调用序列。
微软的 Agent Lightning 团队给这两种模式命名(He et al., 2026):
在传统 agentic RL 中,训练引擎拥有环境交互循环。在 harnessed agentic RL 中,harness 拥有这个循环,训练引擎只观察一串 LLM 请求-响应对。
harness 内部千差万别,但每一个都必须调用模型,而模型 API 是唯一保证存在于 harness 之外的接口。其他一切,harness 的状态和环境的内部状态,对训练器都是隐藏的。
KAT-Coder 报告(KwaiKAT Team, 2026)用这些术语描述 harness 如何组织它的轨迹。它把 Mini-SWE-Agent 称为白盒,因为它循环简单、不做轨迹压缩;把 Claude Code、Codex、OpenClaw 和 OpenHands 称为黑盒,因为它们会压缩并重组上下文。在本文中,区分标准是谁拥有 rollout 循环:训练器还是 harness。上下文处理与循环归属是两个独立的决定。
把循环移进 harness 改变了两件事。第一件是:每次调用由谁发出、按什么顺序。
不同的 token 序列可能产生相同的文本。如果只保存文本再重新分词,得到的 token ID 可能与模型实际采样到的不同。TRL 的文档直接点明:
在 RL 中,你优化的是模型实际产生的那些 token(Gallouédec & Rasul, 2026)。
当 harness 构造下一条提示时,它可能给工具调用加上角色标记或改变空白字符。有些 harness 还会修复格式错误的 JSON。如果训练器从这份被编辑过的文本中学习,它可能用一条模型从未生成过的响应去更新模型。
生成期间还必须记录概率。在异步 RL 中,模型可能在一次 rollout 被采样之后已经更新。用当前权重重新计算对数概率,无法还原那次 rollout 期间使用的概率。重要性采样比较的是当前概率与生成时使用的概率;如果两边都用当前值,即使策略已经不同,比值也会是 1。
记下当时的概率
03 · 为什么要跨 harness 训练
3.1 基准分数现在都带着 harness 标签
模型卡已经开始说明某个分数来自哪个 harness。GLM-4.7 宣称在 Claude Code、Kilo Code、Cline 和 Roo Code 等主流 agent 框架的复杂任务上有显著提升(Z.ai, 2025)。Kimi K2 把 Terminal-Bench(Merrill et al., 2026)报了两遍:在 Terminus 下是 25.0,在 Moonshot 自家框架下是 30.0(Kimi Team, 2025)。MiniMax M2 给它列出的几乎每个基准都标注了 harness(MiniMax, 2025)。DeepSeek-V3.2 的思考模式在 Terminus 下根本跑不起来,所以它的 Terminal-Bench 数字只能来自另一个 harness(DeepSeek-AI, 2025)。
harness 甚至能改变哪个模型胜出。Zhang et al.(2026)取了三个在公开编码排行榜上彼此相差三分以内的模型:GLM-5.1、GPT-5.4 和 Kimi K2.6。他们在三种 harness 配置下、把其他一切保持不变,让这三个模型跑相同的 100 道 SWE-bench Verified(Jimenez et al., 2024)任务。三种配置层层递进:Minimal 有冗长工具、无上下文压缩、无重试;Improved 精简工具并加上压缩和重试;Full 再加上自检、漂移检查和回滚。
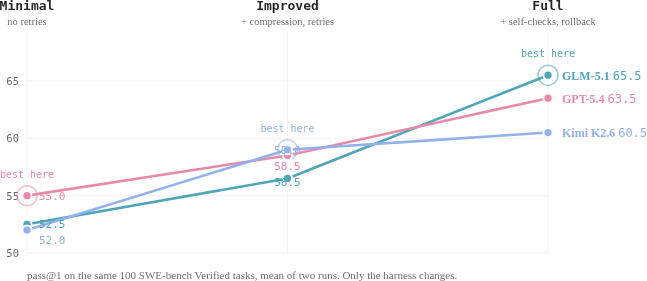
图 2| 同一百道 SWE-bench Verified,三个模型,三种 harness 配置。谁排第一跟着配置走。
04 · 框架如何工作
框架由三部分组成。OpenEnv 是 harness、环境和训练器共同连接的接口,它的捕获代理(capture proxy)记录 token。Harbor 提供任务和沙箱。TRL 在代理记录的内容上训练。本章先跟随一次 rollout 走完整个链路,再逐一介绍各部分。
4.1 OpenEnv
OpenEnv 是 RL 环境的标准接口(Meta PyTorch & Hugging Face, 2025)。它通过客户端-服务端传输提供 Gymnasium 风格的 reset、step 和 state,带类型化动作与观察,打包为 Docker 并可发布到 Hub。它最初是 Meta PyTorch 与 Hugging Face 的合作项目,现在托管在 huggingface/OpenEnv,由十二家组织的委员会治理,采用 BSD-3-Clause 许可。
在本文中,OpenEnv 是 harness、环境和训练器都连接到的共享接口。它不训练任何东西,也不定义奖励。捕获代理记录 RL 训练需要的、来自任何调用模型 API 的智能体的数据。Harbor 集成(Kolavi, 2026)把 Harbor 的容器化任务作为 OpenEnv 环境提供,每个 rollout 可自选 harness 和沙箱。
通过类型化 TrainingTrace API 训练需要 OpenEnv 0.7.0 或更高版本,Harbor 附加包需要 Python 3.12。在 Python 3.10 或 3.11 上,openenv[harbor] 不会安装 Harbor 依赖。harbor_env 包同样来自仓库的 envs/ 目录,而不是 OpenEnv 的 wheel。对 main 分支的检出:
# Run in a Python 3.12 virtual environment.
git clone --depth 1 --branch main https://github.com/huggingface/OpenEnv.git
python -m pip install -e './OpenEnv[harbor]'
export PYTHONPATH="$PWD/OpenEnv/envs${PYTHONPATH:+:$PYTHONPATH}"
训练器和推理服务的依赖及双 GPU 启动命令,参见 TRL 的 Harbor 示例。
4.2 一次 rollout,端到端
在逐部分介绍之前,先看整条路径。下图跟踪一次来自 SmolDataEnvs 的任务 rollout,穿过系统的每一部分。这次 rollout 有三轮对话。SmolDataEnvs 是基于真实 Kaggle 笔记本构建的数据分析任务套件。切换 harness 只改变 Harbor 把它接到代理的方式、模型调用与回复的格式,以及工具的名称。
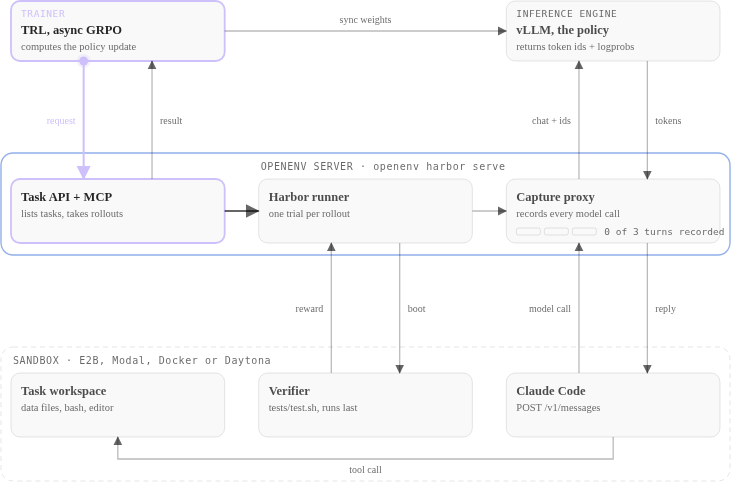
图 3| 训练器更新策略,推理引擎吐出 token id 和 logprobs。捕获代理记下每一次模型调用,沙箱里的 harness 自己跑工具。
4.3 捕获代理
harness 找到代理的方式与找到任何模型服务商一样:通过 base URL 和 API key。这个 API key 是为该 rollout 铸造的捕获会话 ID,这就是为什么一个端口上的同一个代理能服务所有并发的 rollout。携带代理从未注册过的 key 的调用会收到 401。
05 · 跨 harness 训练小模型
我们用上一章的配置训练了 LFM2.5-2.6B,一次只在 OpenCode 里训练,一次跨四个 harness 训练,然后把两次运行都与在更大模型 rollout 上的监督微调做了对比。我们最初的运行用的是 Qwen3.5-2B。它们塑造了 LFM 的配置,放在末尾的可折叠小节里。
5.1 配置
- 任务。1,000 个 SmolDataEnvs 训练任务,400 个中等、600 个困难,按两次运行共用的固定顺序排列。测试集是 250 个留出任务,在笔记本、问题或指令上均无重叠。
- 两次运行。一次只在 OpenCode 中训练。另一次是多 harness(OpenCode、Claude Code、Codex 和 Mini-SWE-Agent),每组八个 rollouts 的 GRPO(Shao et al., 2024)使用四个 harness 之一。
- 评估。两次运行以相同方式评估,包括在 OpenCode-only 运行从未训练过的三个 harness 下评估。每 100 步,250 个测试任务中的每一个在四个 harness 下各跑一次,共 1,000 个单元(cell)。一个单元在首次评分尝试正确时计为已解决。
- 配方。TRL 中的异步 GRPO,跑 1,000 步。异步意味着生成与训练分开进行。一块 H100 训练,另一块用 vLLM(Kwon et al., 2023)服务策略并持续产出 rollouts,训练从不为最慢的智能体等待。代价是 rollouts 通常来自落后两个优化步的权重,从不落后超过四个。
- 硬件与时间。每次运行在 Hugging Face 集群上两块 H100,每个 rollout 一个 E2B 沙箱(1 CPU、4 GB 内存)。训练耗时:OpenCode-only 运行约 32 小时,多 harness 运行约 46 小时,未计入评估、排队与重启。我们没有把总成本跟踪到可以引用的程度。
配套教程提供可读的多 harness 与原生 OpenCode 训练脚本,以及 HF Jobs 和 Slurm 说明。文中报告的 LFM 运行使用 Harbor 提供策略和 E2B 沙箱。当前教程改用 Daytona,并把原生 OpenCode 作为独立对照,因此并非对历史运行的精确重放。
每个单元只跑一次,所以相邻检查点之间的一两个百分点是噪声。相信跨检查点的趋势,而不是任何单点。
5.2 基础模型的起点
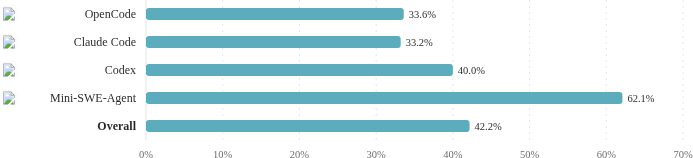
图 4| 还没训练时,OpenCode 和 Claude Code 都在 33% 附近,Codex 是 40%,Mini-SWE-Agent 是 62%。总体 42.2%。
工具效率:对用更少调用得到正确答案的小奖励,最多 0.1。错误答案仍计 0 分,所以模型不能靠提前放弃赚取奖励。
这个奖励来自 Qwen 运行。它们只奖励正确性。这给了模型一旦拿到答案就没有理由停止探索,在早期一次 Qwen 运行中,每个 rollout 的工具调用从 13 次爬到 41 次。
多 harness SFT:全部 3,189 个 rollouts、17,929 个样本,混洗在一起,不做 harness 间的均衡。
两者都用 TRL 的 SFT trainer 做了完整微调,两轮 epoch,学习率 3e-6,有效批大小 8。每个 epoch 用与 RL 运行相同的 1,000 个测试单元评估。
数据以 SmolDataEnvs-multiharness-sft 公开。它有每个 harness 一个配置、四个合在一起的 all 配置,以及已为 LFM2.5-2.6B 和 Qwen3.5-2B 分好词的配置,旁边是训练脚本。原始教师 rollout 在 qwen38-27b-harbor-rollouts。
两种方法学到的东西不同:
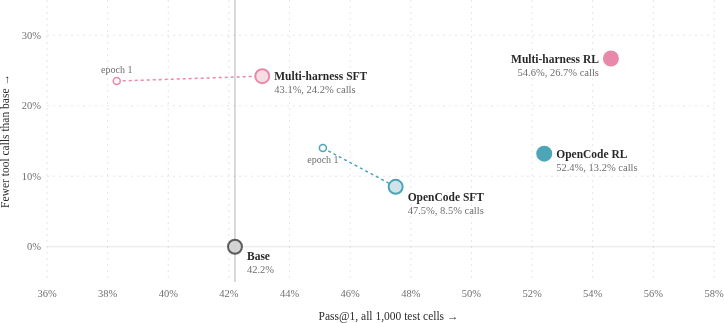
图 5| 横轴是 1,000 个测试单元上的 Pass@1,纵轴是比基础模型少用的工具调用。多 harness RL 停在右上,54.6% 和少 26.7% 的调用。
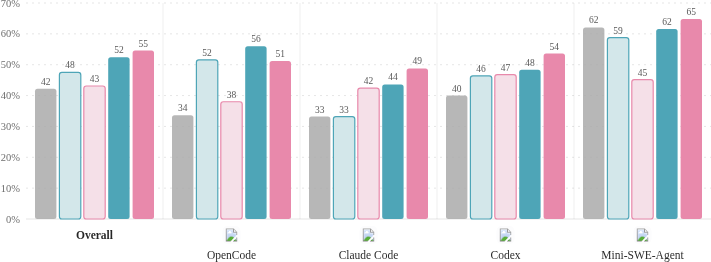
图 6| 四个 harness 各自一排柱。总体从 42 到 55。Mini-SWE-Agent 一排都在高处。
SFT 的时间只算训练器自己的循环,不含收集教师 rollout 的时间。后者曾带着一个 27B 模型走遍全部四个 harness。
5.3 结果
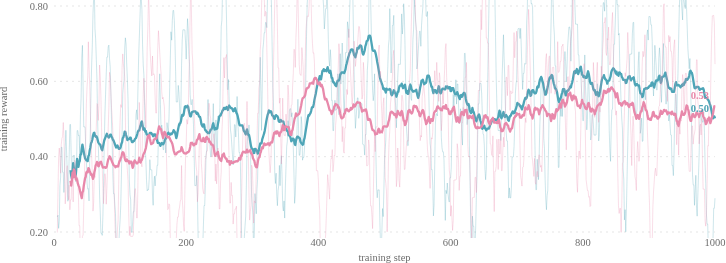
图 7| 训练奖励从 0.3 附近爬到 0.5 以上。细线是每一步的抖动,粗线是平滑后的两条运行。
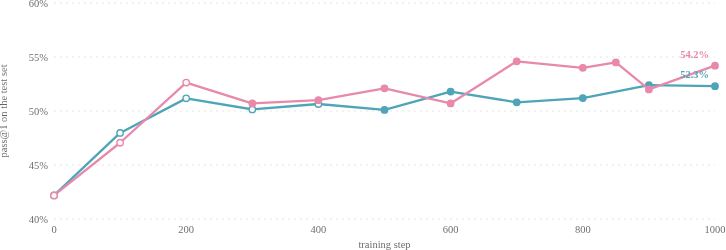
图 8| 留出集 Pass@1 从 42% 附近爬上去。两条线的终点标着 54.2% 和 52.4%。
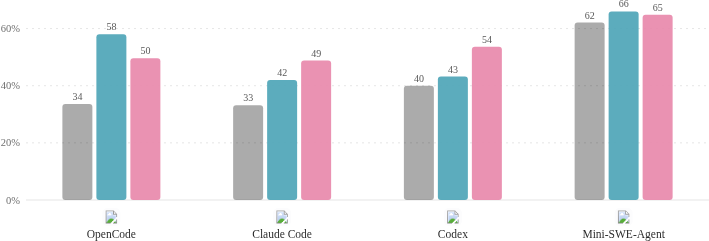
图 9| 四个 harness 各三根柱。OpenCode 上最高的一根是 58,Mini-SWE-Agent 三根都在 60 上下。
- Harbor OpenCode-only:同一条流水线,只用单个 harness。
- Standalone OpenCode:OpenCode 在 Harbor 之外的独立环境(Daytona)中运行。
- OpenCode-only 一直有效但没能完成。每任务调用数从 17 升到 21;在跟踪提交的单元中,提交答案的比例从 69% 降到 41%。
- 一个恢复(resume)bug 重放了旧任务。多 harness 运行在第 684 步重启后,几乎每个新 rollout 都来自它已经见过的任务。这改变了它后期的训练,但下滑始于第 500 步、在重启之前,所以这个 bug 解释不了下滑的开端。
只训一个会偏
5.4 无奖励时的工具调用
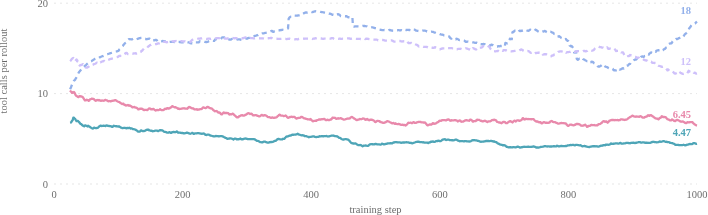
图 10| 虚线往上走,终点在 18 和 12。实线往下走,终点在 6.45 和 4.47。只奖正确性时,调用次数会爬上去。
当正确性作为唯一奖励时,Qwen OpenCode-only 运行中每个 rollout 的工具调用在训练期间从约 10 次翻倍到 20 次,而 Qwen 多 harness 运行保持在 11 到 16 次。在都有奖励的两次 LFM 运行中,工具调用都下降了。
- Claude Code 主导了训练数据。每个 harness 获得约四分之一的 rollouts,但 Claude Code 产出了 77% 的训练行和 35% 的监督 token。
- SETA 是纯 bash 环境中带自有评估器的同步运行,在 150 步内从 18.8% 升到 38.0%,随后我们有意停止。
- 更困难的数据没能救回下滑。在第 500 步的检查点上用 500 个新困难任务继续多 harness 训练(H200,经 Hugging Face Jobs),没能恢复峰值。它近三分之二的步数没有奖励对比,即使把每个未评分的单元都算作正确,最终分数也达不到起点 37.0%。
5.5 LFM 改了什么
LFM 的配置改了三件事。奖励加入了工具调用奖励,因此全对分组仍带有信号,长而不完成的循环要付出代价。训练池改为中等与困难任务。输出上限在训练和评估中都设为 4,096 token,模型学不到评估会截断的答案。
5.6 复现
- SmolDataEnvs Multi-harness RL 集合:下面所有内容一处放齐,外加基础模型。
- 训练模型:第 1,000 步的 LFM 多 harness RL 与 OpenCode-only RL,最佳检查点(第 700、900 步)在 step-700 与 step-900 分支上;epoch 2 后的 LFM 多 harness SFT 与 OpenCode SFT;以及最佳 Qwen 检查点,多 harness(第 500 步)、OpenCode-only(第 700 步)与 standalone OpenCode(第 1,000 步)。
- 训练对比仪表盘:每一条训练曲线与检查点评估。
- Harbor 环境与 standalone OpenCode 环境:当前配套环境服务端。自 OpenEnv 0.7.0 起 standalone opencode_env 已弃用,保留用于历史对比;新运行应使用 Harbor 并设
harness="opencode"。 - SmolDataEnvs-multiharness-sft:SFT 数据,按 harness 划分,已为 LFM2.5-2.6B 与 Qwen3.5-2B 预分词,带训练脚本。
- 已合并的集成:捕获代理与 Harbor 的 OpenEnv #1036、类型化 TrainingTrace API 的 OpenEnv #1280、worker 的 TRL #6947。完整训练器接线见 TRL 的 Harbor 示例;在该 worker 发布前请从 main 安装 TRL。
本文每一次运行都使用 2 到 26 亿参数的小模型,单一种子训练 1,000 步。我们正在用同一套技术栈、更大的模型筹备更大的运行,结果就绪后会在这里补充。敬请期待。
06 · 结论
结果汇总截至 2026 年 9 月 29 日。文章更新于 2026 年 10 月 1 日。
在我们的小模型实验中,多 harness RL 同时改善了任务表现和工具使用。在 SmolDataEnvs 上,LFM2.5-2.6B 的 pass@1 从 42.2% 升到 54.2%,四个 harness(OpenCode、Claude Code、Codex 和 Mini-SWE-Agent)下都有提升。只在 OpenCode 中训练也能提升模型,包括在其他 harness 下,但多 harness 运行把效率提升扩散到了全部四个 harness。一个小型开源模型可以通过同一条训练流水线学会更好地与多个 agent 接口协作。
工具效率奖励把智能体解决问题的方式变成了训练目标的一部分。我们更早的 Qwen 运行只奖励正确性,有些模型学会了制造越来越长的工具调用序列。对 LFM,我们为用更少调用得到正确答案添加了小额奖励。训练期间工具调用下降。在最终检查点上,多 harness 模型在它和基础模型都解决的留出任务上少用了 31% 的工具调用,每个 harness 下都有节省。这个奖励还给 GRPO 提供了学习信号:当一组里所有可评分 rollout 都正确但调用次数不同时。正确性仍然不可或缺:错误答案拿不到效率奖励。
OpenEnv 的捕获代理让这一切变得可行,无需改写 harness,也无需为每个 harness 单独搭建训练循环。配合兼容的推理后端,它记录训练需要的精确提示与补全 token、生成对数概率和损失掩码。Harbor 提供任务和沙箱,同一个 TRL 训练器从产生的轨迹中学习。harness 保留自己的工具、上下文管理和执行循环。切换产出 rollouts 的 harness,不需要在训练器内部重新实现这些行为。
这些只是单一任务族上的小实验,每种配置一个种子,数据和计算暴露也不均衡。它们支撑了对基础模型的提升,但并未确立 harness 组合的通用排名。在这些运行中,RL 带来的精度提升大于 SFT;SFT 也减少了工具使用。我们没有在缺少效率奖励的情况下运行 LFM,所以它的贡献无法与配方中的其他改动分离。
更广阔的机遇是:在人们实际使用的接口上,同时为成功答案和高效执行训练模型。这项工作提供了一条开放、可行的路径:保留真实的 harness,捕获学习所需的证据,让模型在与 harness 自身的交互中变得更好。
07 · 引用
学术场合引用本工作,请使用:
Adithya S Kolavi, Joel Niklaus, Sergio Paniego Blanco, Leonie Monigatti, Amine Dirhoussi, Ben Burtenshaw, Lewis Tunstall, Leandro von Werra (2026). “The ultimate guide to multi-harness RL”.
@misc{kolavi2026_the_ultimate_guide_to_multi_harness_rl,
  title={The ultimate guide to multi-harness RL},
  author={Adithya S Kolavi and Joel Niklaus and Sergio Paniego Blanco and
          Leonie Monigatti and Amine Dirhoussi and Ben Burtenshaw and
          Lewis Tunstall and Leandro von Werra},
  year={2026},
}